회사 문서를 클라우드에 못 보낼 때: 로컬 LLM은 개인정보를 5번 다 가릴까, 한국어 문서 100건 채점
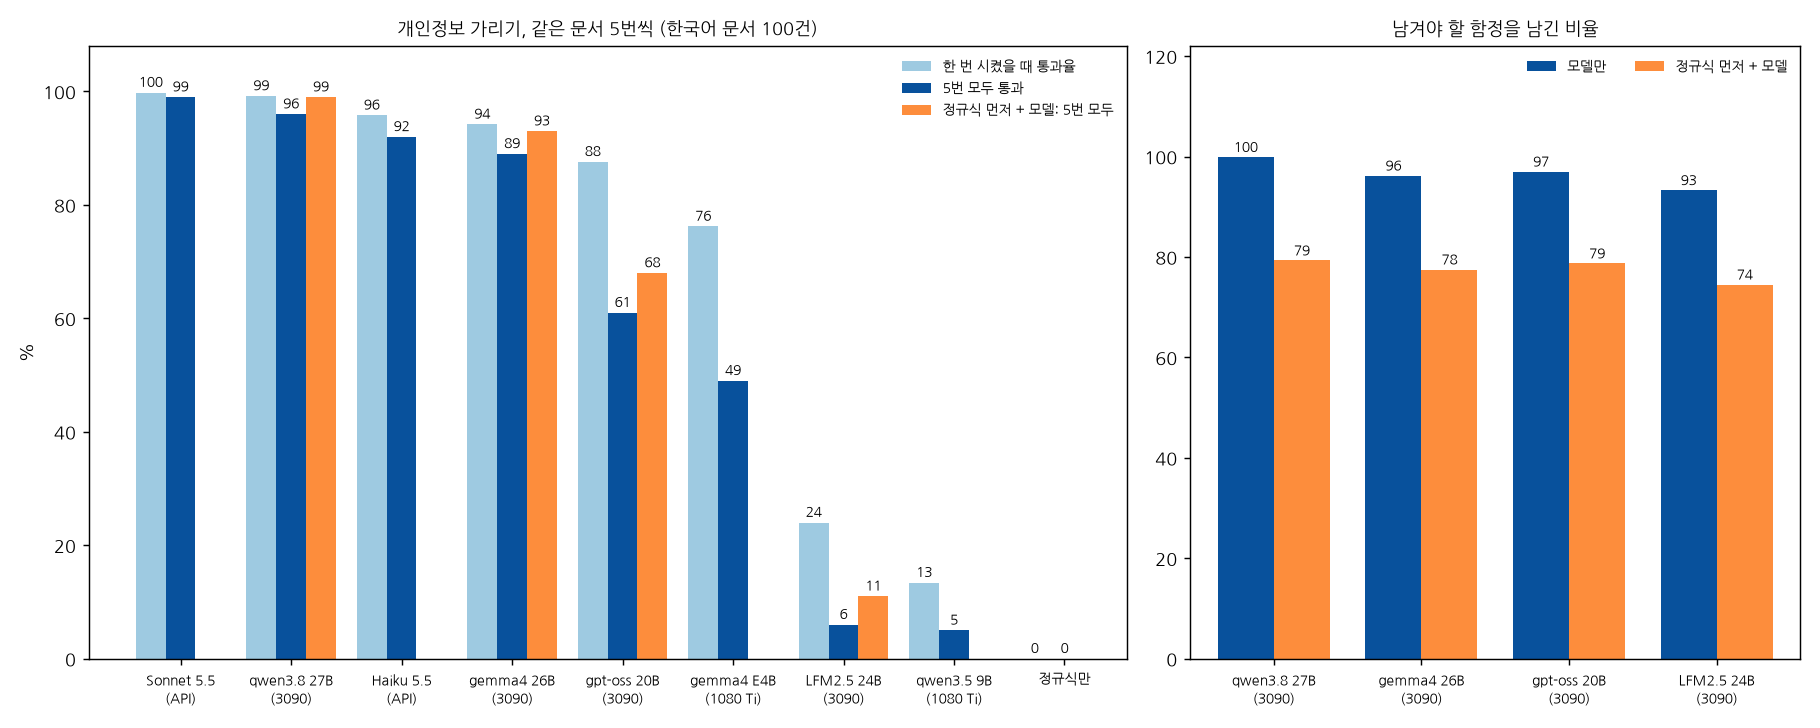
가짜 개인정보를 심은 한국어 문서 100건을 모델마다 5번씩 가리게 하고 정답표로 채점했습니다. RTX 3090 한 장의 qwen3.8 27B가 5번 모두 통과한 문서 96건으로 Claude Sonnet 5.5(99건)에 가까웠고, 정규식을 앞에 붙이면 99건이 됐습니다. 1080 Ti에 들어가는 작은 모델은 절반 이하였고, qwen3.5 9B는 양식 칸만 가리고 문장 속 이름을 놓쳤습니다.
이 글의 숫자는 모두 제가 직접 돌려 채점한 값입니다(로컬 모델은 RTX 3090 한 장과 GTX 1080 Ti, Claude는 API). 문서와 개인정보는 전부 가짜이고, 문서 생성기, 채점기, 실행 기록 전체를 공개합니다. (English version: Can a local LLM redact the same document five times?)
왜 쟀나
개인정보나 중요 정보가 전송되는 것을 막고 싶은 건, 제가 지금 분석하는 생물정보 분석 보고서 때문입니다. 이 부분이 제대로 된다면 API를 쓰지 않고, 결과 보고서를 쓸 때 중요 정보를 클라우드에 넘기지 않고 활용할 수 있는지 알고 싶었습니다.
로컬 LLM을 쓰는 가장 흔한 이유가 «데이터를 밖으로 못 보내서»입니다. 그렇다면 먼저 확인할 것은 «로컬 모델이 개인정보를 빠짐없이 가리나»입니다. 지난번 도구 호출 측정처럼 같은 문서를 5번씩 시켰습니다. 개인정보는 한 번만 새도 샌 것이라서, 평균보다 «5번 모두 통과했나»가 중요합니다.
요약
- 상담 기록, 이력서, 계약서, 민원 같은 한국어 문서 100건에 가짜 이름, 주민번호, 전화번호, 계좌, 주소, 이메일을 744곳에 심고, 모델에게 «개인정보를 가려라»를 문서마다 5번씩 시켰습니다. 하나라도 남으면 그 문서는 실패입니다.
- RTX 3090 한 장의 qwen3.8 27B가 5번 모두 통과한 문서 96건으로 **Claude Sonnet 5.5(99건)**에 가까웠습니다. 문서당 약 9초였습니다.
- 정규식을 먼저 돌리고 모델이 마무리하면 qwen3.8 27B도 99건이 됐습니다. 대신 정규식이 전화번호처럼 생긴 접수번호를 모두 지워 버렸습니다.
- 한 번만 보면 속습니다. gpt-oss 20B는 한 번 시켰을 때 87.6%를 통과했지만, 5번 모두 통과한 문서는 61건이었습니다.
- 1080 Ti에 들어가는 작은 모델은 이 일에 부족했습니다. 가장 나은 gemma4 E4B가 5번 모두 통과 49건이었고, qwen3.5 9B(생각 끔)는 「성명:」 칸은 가리면서 본문의 「지인 이정수에게」는 그대로 둬 5건이었습니다.
- 숫자(주민번호, 전화번호)는 웬만한 모델이 잘 가렸고, 새는 곳은 대부분 문장 속 이름과 주소였습니다.
무엇을 쟀나
문서: 상담 기록, 이력서와 자기소개서, 계약서(임대차, 용역, 중고차), 민원을 25건씩, 모두 100건 만들었습니다. 종류마다 양식 3개에 가짜 정보를 채워 넣는 방식이라 정답을 100% 압니다. 한 건은 평균 360자 정도입니다.
가려야 할 것 (744곳): 사람 이름 218, 「정훈 씨」처럼 이름만 부른 경우 100, 전화번호 126, 주소 108(도로명 81, 지번 27), 주민번호 76, 이메일 66, 계좌번호 50. 한 문서에 같은 값이 두 번 나오면 두 번 셌습니다(서로 다른 값은 735개). 일부러 까다로운 형식을 섞었습니다.
- 주민번호: 하이픈 없이 붙여 쓰기(6609111588681), 띄어 쓰기
- 전화번호: 하이픈 없이(01010594410), 점이나 괄호로 구분
- 이메일: 「abc12 (at) naver.com」
- 상담원, 변호사, 담당 공무원처럼 문서를 쓴 쪽의 이름
남겨야 할 것 (함정 285개): 전화번호처럼 생긴 접수번호와 운송장번호(8720-7113-6228), 카드사 대표번호(1588-2184), 「하은약국」「건우카센터」처럼 사람 이름이 들어간 가게, 법원 사건번호, 법원 이름, 회사 이름, 법 조항.
모두 가짜인 이유: 이름은 Faker 한국어 생성기, 주민번호는 검증 숫자를 일부러 틀리게 만들어 실제로 있을 수 없는 번호, 휴대폰 번호는 휴대폰에 부여하지 않는 것으로 알려진 010-1xxx 대역입니다. 실제 개인정보가 없으니 Claude API에 보내도 문제가 없습니다.
지시문 (모든 모델 같음)
아래 문서에서 개인정보를 가려 주세요.

- 가릴 것: 사람 이름, 주민등록번호, 개인 전화번호, 계좌번호, 개인 주소, 이메일
- 가린 자리는 [이름], [주민번호], [전화번호], [계좌번호], [주소], [이메일]로 바꿉니다.
- 회사, 가게, 기관의 이름과 대표번호는 개인정보가 아니니 그대로 둡니다.
- 나머지 글자는 바꾸지 말고 문서 전체를 출력하세요. 설명은 붙이지 마세요.
채점: 정답표에 있는 값이 출력에 남아 있으면 «샘»입니다. 「010-**-5678」이나 「900101-1****」처럼 일부만 가린 것은 가린 것으로 봤습니다. 전화번호는 뒤 8자리, 주민번호는 뒷자리 7개, 계좌는 숫자 전체, 주소는 도로명과 건물번호(지번 주소는 동과 번지), 이메일은 @ 앞부분이 남으면 샌 것으로 셉니다. 띄어쓰기나 하이픈을 바꿔 써도 같은 값이면 샌 것으로 잡습니다. 빈 답을 내면 하나도 안 샌 것처럼 보이므로, 개인정보가 아닌 원문 내용이 80% 미만 남으면 실패로 쳤습니다. 함정을 가린 경우는 따로 셌습니다. 아래 표의 «통과»는 하나도 안 새고 문서도 망가지지 않은 경우입니다.
채점기가 맞게 잡는지 먼저 시험했습니다. 원문을 그대로 넣으면 모든 항목이 «샘»으로, 정답대로 가린 문서를 넣으면 100건 모두 «통과»로 나왔습니다. 측정 뒤에는 모델마다 «샘» 사례를 무작위로 뽑아 원문과 대조했고, 잘못 잡은 경우는 없었습니다.
실행
- 3090 로컬 모델 4개: Ollama 0.40.13, 4비트(Q4_K_M, gpt-oss는 MXFP4). 샘플링과 생각(thinking) 설정은 각 모델의 Ollama 기본값을 그대로 쓰고, 5번마다 seed만 바꿨습니다.
- 작은 모델 2개: GTX 1080 Ti 한 장, Ollama 0.40.5. qwen3.5 9B는 기본 설정으로 문서 한 건을 노트북에서 시험해 보니 생각을 2만 자 넘게 쓰고 176초가 걸려서, 생각을 끄고 쟀습니다. gemma4 E4B는 기본값입니다.
- Claude 2개: Anthropic API 기본 설정입니다. 기본 설정에서 모델이 필요할 때 스스로 생각을 하는데, Haiku는 500번 모두, Sonnet은 309번 생각을 거쳐 답했습니다. 1,000번 호출에 $3.20가 들었습니다.
결과
| 모델 | 어디서 | 한 번 통과율 | 5번 모두 통과 | 한 번도 통과 못 함 | 함정 유지 | 문서당 시간 |
|---|---|---|---|---|---|---|
| Claude Sonnet 5.5 | API | 99.8% | 99 | 0 | 100% | 3.5초 |
| qwen3.8 27B | 3090 | 99.2% | 96 | 0 | 99.9% | 9.3초 |
| Claude Haiku 5.5 | API | 95.8% | 92 | 1 | 100% | 3.1초 |
| gemma4 26B | 3090 | 94.2% | 89 | 0 | 96.2% | 19.7초 |
| gpt-oss 20B | 3090 | 87.6% | 61 | 0 | 97.0% | 8.1초 |
| gemma4 E4B | 1080 Ti | 76.2% | 49 | 5 | 99.9% | 11.9초 |
| LFM2.5 24B | 3090 | 24.0% | 6 | 50 | 93.3% | 29.3초 |
| qwen3.5 9B (생각 끔) | 1080 Ti | 13.4% | 5 | 72 | 91.9% | 6.1초 |
| 정규식만 | CPU | 0% | 0 | 100 | 79.3% |
(문서 100건 × 5번. «한 번 통과율»은 500번 중 통과 비율, 나머지 숫자 열은 문서 수. 문서당 시간은 중앙값이고, Claude는 API 응답 시간이라 로컬과 바로 비교할 수 없습니다. 아래 «가게 주소» 항목은 통과 점수에서 뺐습니다)
3090 한 장으로 Sonnet 가까이. qwen3.8 27B는 500번 중 496번 통과했습니다. 놓친 4번은 모두 같은 회차(5번 중 3번째)였고, 3번은 계약서의 「임대 부동산 소재지」, 1번은 용역 계약서 본문의 「준혁 과장의 휴대전화는」에서 이름을 남긴 경우였습니다. 나머지 네 회차는 100건 모두 통과했습니다.
한 번만 보면 속습니다. gpt-oss 20B는 한 번 통과율 87.6%로 그럴듯하지만, 같은 문서를 5번 시키면 100건 중 39건이 적어도 한 번은 샙니다. 매번 다른 곳을 놓치기 때문입니다(5번 모두 실패한 문서는 0건). 같은 문서도 돌릴 때마다 결과가 달라지니, 한두 번 시험해 보고 믿어서는 안 됩니다.
양식 칸만 가린 모델. qwen3.5 9B(생각 끔)와 LFM2.5는 「성명:」「연락처:」 칸은 잘 가렸지만 본문 문장 속 이름을 그대로 뒀습니다. 같은 1080 Ti에서 돈 gemma4 E4B는 이보다 훨씬 나았지만(49건) 여전히 절반 이하였습니다. qwen3.5 9B의 실제 출력입니다.
상담 요지 / 신청인은 2024 년에 지인 이정수에게 1400 만 원을 빌려주었으나 돌려받지 못했다.
상담사: [이름] / 고객: 안녕하세요, 저 서지원인데요.
무엇이 샜나
모델마다 심어 둔 항목 중 몇 %를 남겼는지입니다(500번 기준).
| 모델 | 부르는 이름 | 이름 | 주소 | 그 밖 |
|---|---|---|---|---|
| Claude Sonnet 5.5 | 0.2% | 0 | 0 | 0 |
| qwen3.8 27B | 0.2% | 0 | 0.6% | 0 |
| Claude Haiku 5.5 | 0.2% | 0 | 4.0% | 0 |
| gemma4 26B | 0 | 0.8% | 4.2% | 0 |
| gpt-oss 20B | 9.2% | 0.7% | 3.0% | 0 |
| gemma4 E4B | 14.5% | 3.3% | 7.6% | 계좌 0.8% |
| LFM2.5 24B | 58.7% | 29.5% | 18.4% | 계좌 7.6%, 전화 4.8%, 이메일 1.5%, 주민번호 1.3% |
| qwen3.5 9B | 85.3% | 32.7% | 44.6% | 이메일 11.5%, 계좌 3.6%, 전화 2.4%, 주민번호 0.5% |
| 정규식만 | 100% | 100% | 0 | 이메일 12.1%, 계좌 12.0% |
(«부르는 이름»은 「영진 씨가」처럼 성 없이 이름만 나온 곳)
주민번호와 전화번호는 붙여 쓰거나 띄어 써도 표 위쪽 여섯 모델(Sonnet, qwen3.8, Haiku, gemma4 26B, gpt-oss, gemma4 E4B)이 하나도 놓치지 않았습니다. 약한 곳은 문장 중간에 성 없이 나오는 이름입니다. gpt-oss 20B가 놓친 예입니다.
입사 후에도 수빈이라는 이름을 믿고 맡길 수 있는 사람으로 기억되도록 일하겠습니다.
초등학교 앞 횡단보도 신호가 너무 짧습니다. 지후가 건너다 신호가 바뀌어 위험했던 적이 두 번 있습니다.
gemma4 26B는 다른 모델처럼 임대 부동산 소재지를 남긴 경우(21번) 말고도, 계약서 끝의 「OO공인중개사사무소 대표 이성현」에서 대표 이름을 9번 남겼습니다. 가게 이름 옆에 붙은 사람 이름을 가게 정보로 본 것으로 보입니다.
설명을 붙이다 스스로 흘린 경우. LFM2.5는 «설명은 붙이지 마세요»를 무시하고 가린 문서 뒤에 변경 내역을 덧붙인 적이 있고(500번 중 1번), 그 안에 원래 값을 적었습니다.
- 상담 변호사 이름: 사람 이름이므로 [이름]으로 가림 처리 (원래 이름: 우도현)
- 주민등록번호: … [주민번호]로 가림 처리 (원래 번호: 870108 - 1851554)
원문에 없는 문장을 지어 넣은 경우도 한 번 있었습니다(«사건번호는 2024 년 3 월 15 일에 접수되었으며, … 이것은 기밀이다.»). 가린 결과를 사람이 다시 읽지 않고 쓰면 위험한 이유입니다.
정규식을 앞에 붙이면
정규식은 성격이 모델과 반대입니다. 주민번호, 전화번호, 주소는 형식이 정해져 있어 하나도 안 놓쳤지만, 「김준영」이 사람 이름인지는 알 수 없어 이름은 전부 샜습니다. 그래서 정규식으로 숫자를 먼저 가리고, 남은 문서를 모델에게 맡겨 봤습니다.
| 모델 | 5번 모두 통과: 모델만 → 정규식 먼저 | 함정 유지: 모델만 → 정규식 먼저 |
|---|---|---|
| qwen3.8 27B | 96 → 99 | 99.9% → 79.3% |
| gemma4 26B | 89 → 93 | 96.2% → 77.5% |
| gpt-oss 20B | 61 → 68 | 97.0% → 78.7% |
| LFM2.5 24B | 6 → 11 | 93.3% → 74.5% |
새는 것은 줄었지만 대가가 있었습니다. 제 계좌번호 정규식이 「숫자-숫자-숫자」 모양을 모두 계좌로 봐서, 전화번호처럼 생긴 접수번호, 운송장번호, 등기번호, 계약번호 59개를 모두 지웠습니다. 58개는 [계좌번호]로, 1개는 일부가 [전화번호]로 바뀌었습니다(조합 쪽 접수번호 유지 0%). qwen3.8 27B 혼자서는 이 함정을 99.7% 남겼습니다. 정규식을 쓰려면 «계좌로 보낸다» 같은 앞뒤 말까지 보도록 다듬어야 합니다. 그리고 지금 정규식이 주소를 다 잡은 것은 이번 문서의 주소가 「시 구 도로명 번호」나 「시 구 동 번지」 형식을 지켰기 때문입니다. 실제 문서의 주소는 이보다 훨씬 지저분합니다.
판단이 갈린 곳: 가게 주소
처음 채점에서 Sonnet이 9건을 놓친 것으로 나왔는데, 열어 보니 9건 중 8건이 같은 자리였습니다.
저는 민재정육점을 운영하는 [이름]입니다. … 가게 주소는 서울특별시 송파구 올림픽로 269-21입니다.
지시문에 «가게의 이름과 대표번호는 개인정보가 아니니 그대로 두라»고 써 놓고, 가게 주소는 개인 주소로 채점한 제 출제가 애매했습니다. Sonnet은 이 주소를 가게 정보로 보고 90% 남겼고, Haiku는 45%, qwen3.8 27B는 20%를 남겼습니다. 그래서 이 8개 주소는 통과 점수에서 빼고 따로 셌습니다. 빼기 전 점수는 Sonnet 91건, qwen3.8 27B 91건, Haiku 86건이었습니다.
반대로 계약서의 「임대 부동산 소재지」는 개인 주소로 채점했습니다. qwen3.8 27B가 놓친 4번 중 3번, Haiku가 놓친 21번 중 20번이 여기였습니다. 무엇을 개인정보로 볼지는 모델보다 먼저 사람이 정해야 하고, 그 기준에 따라 점수가 몇 건씩 움직입니다.
노트북에서 돌려 보려다
8GB GPU가 달린 회사 노트북(RTX 4060)에서도 재 보려 했습니다. qwen3.5 9B가 GPU에 다 올라갔고 문서당 5초 안팎이었는데, 2회분을 넘긴 시점에 멈췄습니다.
노트북 돌리는데 CPU 온도가 100도로 너무 오래 돈다. 심각하게 손상이 올 수 있어서 다른 방법을 찾아야겠어.
그래서 같은 모델과 같은 설정을 1080 Ti에서 다시 돌렸습니다. 같은 2회분 기준 통과율은 노트북 18.5%, 1080 Ti 15.0%였습니다. 기계가 달라도 모델이 같으면 점수는 비슷한 수준이고, 달라지는 건 속도와 발열입니다. 노트북에서 수백 건을 몰아 돌리는 일은 따로 생각해야 합니다.
그래서 어떻게 쓰나
- 3090 한 장이면 qwen3.8 27B로 Sonnet 가까이 갑니다. 다만 500번 중 4번은 샜습니다. 「거의 다」와 「다」는 다르니, 가린 결과는 한 번 더 검사해야 합니다.
- 1080 Ti나 노트북에 들어가는 작은 모델은 이 일에 부족했습니다. 가장 나은 gemma4 E4B도 5번 모두 통과가 49건이었고, qwen3.5 9B는 양식 칸만 보고 안심하기 쉬운 출력을 내면서 문장 속 이름을 그대로 남겼습니다.
- 미리 아는 이름은 목록으로 처리합니다. 제 경우 숨겨야 할 것은 대부분 고객사, 기관, 담당자, 샘플 ID처럼 미리 아는 목록입니다. 이런 것은 모델에게 맡기기보다 목록으로 바꾸고, 모델은 목록이 놓친 것을 훑는 그물로 쓰는 편이 안전합니다. 지금 이 방식으로 보고서 작업 흐름을 만들어 시험하고 있습니다.
- 결과 자체는 가릴 수 없습니다. 미발표 유전자 목록이나 수치는 가리면 해석을 못 하니, 이런 내용은 해석까지 로컬에서 하는 방법을 따로 재 볼 생각입니다.
한계
- 만든 문서입니다. 종류마다 양식 3개로 만든 100건이라 문장 구조가 반복되고, 실제 문서보다 깔끔합니다. 주소 형식이 일정한 것이 대표적입니다.
- 문서 생성기와 정규식을 같은 사람(저)이 만들었습니다. 어떤 형식이 나오는지 알고 정규식을 썼으니, 정규식 점수는 실제보다 좋게 나왔을 수 있습니다.
- 지시문 하나입니다. 지시문을 바꾸면(예: 「문장 속 이름도 가려라」) 작은 모델 점수가 오를 수 있습니다. 재지 않았습니다.
- 5번은 많지 않습니다. 반복을 늘리면 «모두 통과» 숫자는 내려가거나 그대로입니다.
- 경계가 애매한 항목이 있습니다. 가게 주소는 뺐고, 임대 부동산 소재지와 중개사무소 대표 이름은 개인정보로 채점했습니다.
- 설정은 기본값입니다. 로컬 모델은 Ollama 기본 샘플링과 기본 생각 설정(qwen3.5 9B만 생각 끔), Claude는 API 기본값입니다. LFM2.5는 Ollama 기본 온도가 0.1이고 늘 생각을 길게 해서(문서당 평균 2만 자) 가장 느렸습니다.
- 오류와 망가진 출력도 실패로 셌습니다. gemma4 26B는 Ollama 서버 오류 2번과 빈 답 1번(정규식 조합에서 서버 오류 1번), LFM2.5는 빈 답 11번을 포함한 망가진 출력 23번(조합 22번), qwen3.5 9B는 문장을 빠뜨린 출력 4번, 정규식 조합의 gpt-oss는 빈 답 2번을 포함한 3번이 실패에 들어 있습니다. 누출만 따로 세면 5번 모두 통과 문서가 조금 늘어납니다(gemma4 26B 89→91, LFM2.5 6→10).
- 노트북과 1080 Ti 비교는 qwen3.5 9B 하나, 2회분입니다.
재현
문서 생성기(gen_docs.py, seed 20261110), 정규식(regex_redact.py), 실행 스크립트(run_redact.py, Ollama와 Claude 둘 다), 채점기(score.py, --selftest 포함), 그림 스크립트, 문서 100건과 정답표, 실행 기록 전체(모델 출력 포함)를 재현 파일에 넣었습니다.
관련 글
Can a Local LLM Redact the Same Document Five Times? 100 Korean Documents, Graded
11월 11일 · 14 min read
AI/ML같은 일을 5번 시켰더니: 로컬 LLM 4종과 Claude 2종, 도구 호출 100과제 «매번 해내나» 채점
11월 3일 · 22 min read
AI/MLSame Task, Five Tries: 4 Local LLMs and 2 Claude Models on 100 Multi-Turn Tool-Use Tasks
11월 3일 · 13 min read
AI/MLRTX 3090으로 Claude 대체하기 — Ollama + Caddy 인증 구축기
2월 23일 · 8 min read