같은 일을 5번 시켰더니: 로컬 LLM 4종과 Claude 2종, 도구 호출 100과제 «매번 해내나» 채점
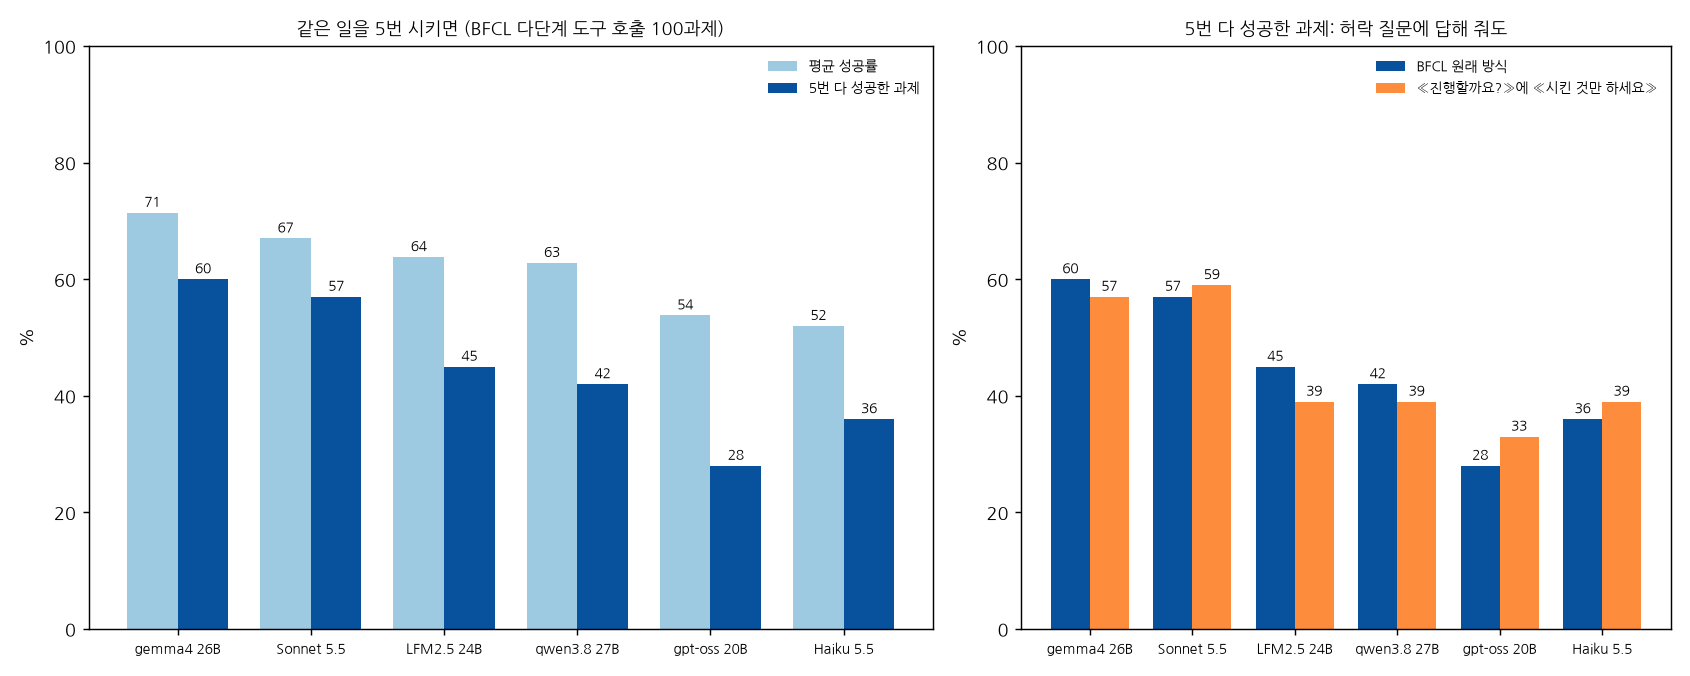
BFCL 다단계 도구 호출 과제 100개를 모델마다 5번씩 시키고 최종 상태로 채점했습니다. 3090 한 장의 gemma4 26B가 5번 다 해낸 과제 60개로 Claude Sonnet 5.5(57개)와 비슷했습니다. «진행할까요?»에 «예»라고 답해 주면 점수가 오히려 떨어졌고, «시킨 것만 하세요»로 답하면 평균 성공률은 거의 그대로였습니다.
이 글의 숫자는 모두 제가 직접 돌려 채점한 값입니다(로컬 모델은 RTX 3090 한 장, Claude는 API). 과제와 채점기는 공개 벤치마크 BFCL의 것을 그대로 썼고, 실행 스크립트와 실행 기록 전체를 공개합니다. (English version: Same task, five tries)
왜 쟀나
클라우드 API 비용도 걱정되고, 로컬로 가능한 모델에 도구 호출을 맡겨 다양한 작업을 진행해 보려고 생각했습니다. 개인적으로 RTX 3090 카드 한 장이 설치되어 있어서, 활용하는 방법을 고민하고 있었습니다.
그래서 «3090 한 장에서 도는 모델에게 도구를 쥐여 주면, 맡긴 일을 매번 해내나»를 재 보기로 했습니다. 한 번 잘하는 것과 매번 잘하는 것은 다른 이야기라서, 같은 과제를 5번씩 시켰습니다.
요약
- 모델에게 «파일 옮기고, 정렬하고, 결과를 트윗해» 같은 다단계 일을 도구를 불러 처리하게 하고, 끝난 뒤 시스템의 실제 상태가 정답과 같은지 기계로 채점했습니다. 모델이 «다 했습니다»라고 말해도 상태가 틀리면 실패입니다.
- 과제 100개를 모델마다 5번씩 시켰습니다. 평균 성공률과 **«5번 다 해낸 과제 수»**는 다른 이야기를 했습니다.
- 3090 한 장에서 도는 gemma4 26B가 5번 다 해낸 과제 60개, 평균 71.4%로 가장 높았고, Claude Sonnet 5.5(57개, 67.0%)와 비슷했습니다.
- qwen3.8 27B는 한 번이라도 푼 과제가 83개로 가장 많았지만, 5번 다 해낸 건 42개였습니다.
- 모델이 «진행할까요?»라고 물을 때 «예»라고 답해 줬더니 점수가 오히려 떨어졌습니다(Sonnet 5번 다 성공 57 → 43). 모델이 덤으로 제안한 일까지 했기 때문입니다. «시킨 것만 하세요»로 답하면 모든 모델의 평균 성공률이 원래와 4점 안쪽이었습니다.
- Sonnet은 시킨 것보다 더 해 주려다 틀리는 경우가 있었습니다. 빈 문서를 만들라는 요청에 5번 모두 제목과 양식을 알아서 써 넣었습니다.
무엇을 쟀나
과제: BFCL(버클리 함수 호출 리더보드) v4의 다단계 과제 multi_turn_base 200개 중 번호가 짝수인 100개입니다(Apache-2.0). 과제마다 가짜 시스템이 실제로 돌아갑니다. 파일 시스템, 주식 거래, 여행 예약, 메시지, 트위터 비슷한 게시판, 차량 제어 등입니다. 한 과제 안에서 사용자 요청이 1~6번 이어집니다.
예를 들면 이런 과제입니다.
- «research 폴더의 research_notes.txt를 archives 폴더에 2024_research_backup.txt라는 이름으로 복사해 줘»
- «방금 만든 파일의 줄을 알파벳순으로 정렬해 줘»
- «정렬된 파일이 몇 줄인지 알려 줘»
채점: BFCL 공식 채점기(pip 패키지 bfcl-eval 2026.3.23)가 모델이 부른 함수를 다시 실행하고, 요청 하나가 끝날 때마다 시스템 상태와 실행 결과를 정답과 비교합니다. 하나라도 다르면 그 과제는 실패입니다.
실행
- 로컬 모델 4개: RTX 3090 한 장, Ollama 0.40.13, Ollama 기본 도구 호출 기능, 문맥 32k. 샘플링은 각 모델의 Ollama 기본값을 그대로 썼고(아래 LFM2.5 참고), 5번마다 seed만 바꿨습니다.
- Claude 2개: Anthropic API, 기본 샘플링(온도 1.0), 확장 사고 없음.
- 모델이 함수를 부르면 제 쪽에서 BFCL 시스템에 실행하고 결과를 돌려주며, 모델이 함수를 부르지 않고 답하면 다음 요청으로 넘어갑니다(BFCL 원래 방식). 요청 하나에 최대 20번까지 부를 수 있습니다.
결과
| 모델 | 어디서 | 평균 성공률 | 한 번이라도 성공 | 5번 다 성공 | 될 때도 안 될 때도 |
|---|---|---|---|---|---|
| gemma4 26B | 3090 | 71.4% | 80 | 60 | 20 |
| Claude Sonnet 5.5 | API | 67.0% | 76 | 57 | 19 |
| LFM2.5 24B (온도 1.0) | 3090 | 63.8% | 78 | 45 | 33 |
| qwen3.8 27B | 3090 | 62.8% | 83 | 42 | 41 |
| gpt-oss 20B | 3090 | 53.8% | 76 | 28 | 48 |
| Claude Haiku 5.5 | API | 52.0% | 69 | 36 | 33 |
(과제 100개 × 5번, BFCL 원래 방식. «평균 성공률»은 500번 중 성공 비율, 나머지 열은 과제 수)
평균과 «5번 다»는 다릅니다. Sonnet과 qwen3.8 27B는 평균이 67.0%와 62.8%로 4%p 차이인데, 5번 다 해낸 과제는 57개와 42개로 15개 차이가 납니다. qwen3.8 27B는 한 번이라도 푼 과제가 83개로 가장 많았으니 «할 줄 몰라서»가 아니라 «매번 같은 길로 가지 않아서» 놓치는 과제가 많습니다. 일을 맡길 때 중요한 건 평균보다 뒤쪽 숫자입니다.
3090 한 장으로 상용 중간급과 비슷한 자리. gemma4 26B는 한 번에 쓰는 파라미터가 작은 MoE 모델이고, 이 시험에서는 5번 다 해낸 과제 수와 평균 모두 Sonnet 5.5와 차이가 크지 않았습니다(60 대 57, 71.4% 대 67.0%). 과제 100개짜리 시험 하나의 결과라 «Sonnet보다 낫다»고 읽지는 마세요.
LFM2.5와 온도. LFM2.5는 Ollama 기본 온도가 0.1이고(모델 카드 권장값), 다른 모델은 모두 1.0입니다. 무작위성이 낮으면 매번 같은 길로 가기 쉬워 «5번 다»에 유리합니다. 그래서 표의 LFM2.5는 다른 모델과 같은 온도 1.0으로 다시 잰 값입니다. 카드 권장값 0.1로 돌리면 평균 67.0%, 5번 다 해낸 과제 55개였습니다.
«진행할까요?»라고 물으면
처음 결과를 보고 Claude 실패 기록을 열어 보니, 모델이 일을 하다 멈추고 «진행할까요?»라고 묻는 경우가 눈에 띄었습니다. BFCL 방식에서는 모델이 함수를 부르지 않고 답하면 그 요청은 끝나므로, 묻는 순간 실패가 됩니다.
깜짝 놀랐지. 클로드가 실패하는 게 무슨 일인가, 잘못된 것을 직감하고 오류를 찾았지.
묻는 모델이 불리하지 않도록 규칙을 하나 더해 다시 쟀습니다. 요청에 대한 답이 허락을 구하는 질문으로 끝나면(«Should I…», «Would you like me to…», «Shall we proceed?» 같은 표현), 사용자가 한 번 답해 주고 같은 요청을 이어 가게 했습니다. 모든 모델에 똑같이 적용했습니다.
1차: «Yes, please go ahead.»로 답했더니 점수가 떨어졌습니다.
| 모델 | 원래 방식 | «예» |
|---|---|---|
| gemma4 26B | 71.4 / 60 | 70.6 / 57 |
| Claude Sonnet 5.5 | 67.0 / 57 | 63.4 / 43 |
| LFM2.5 24B (온도 1.0) | 63.8 / 45 | 47.6 / 21 |
| Claude Haiku 5.5 | 52.0 / 36 | 50.6 / 34 |
(평균 성공률 / 5번 다 성공한 과제. qwen3.8과 gpt-oss는 원인을 찾은 뒤 중단해 빠졌습니다)
실패 기록을 열어 보니 원인은 제 규칙에 있었습니다. 질문을 찾는 규칙이 «시킨 일을 해도 될까요?»만 잡지 않고 «다른 것도 해 드릴까요?»까지 잡았습니다. 여기에 «예»라고 답하면 모델은 아직 시키지 않은 일까지 합니다. 상담 티켓 과제에서 LFM2.5는 티켓 내용을 보여 준 뒤 «설명을 고치거나, 해결 처리하거나, 다른 일을 해 드릴까요?»라고 물었고, «예»를 받자 스스로 지은 사유로 티켓을 해결 처리했습니다. 사용자는 바로 다음 요청에서 다른 사유로 해결을 부탁할 참이었습니다. BFCL은 요청마다 상태를 비교하므로 이런 실행은 실패입니다.
클로드가 다양한 생각을 해서 미리 반응하는구나 생각하고 신뢰가 생겼어. 역시 커머셜한 것을 사용해야 하나 고민도 했어.
2차: «Yes, go ahead with exactly what I asked. Do not do anything beyond that.»로 바꿨더니 평균은 거의 그대로였습니다.
| 모델 | 원래 방식 | «시킨 것만» | 질문으로 끝난 실행 (500번 중) |
|---|---|---|---|
| gemma4 26B | 71.4 / 60 | 70.6 / 57 | 12 |
| Claude Sonnet 5.5 | 67.0 / 57 | 66.4 / 59 | 102 |
| LFM2.5 24B (온도 1.0) | 63.8 / 45 | 60.2 / 39 | 256 |
| qwen3.8 27B | 62.8 / 42 | 59.6 / 39 | 322 |
| gpt-oss 20B | 53.8 / 28 | 54.4 / 33 | 54 |
| Claude Haiku 5.5 | 52.0 / 36 | 54.4 / 39 | 138 |
평균 성공률은 모든 모델이 원래 방식과 4점 안쪽이고, 과제 100개 규모에서는 잡음과 구별되지 않습니다. 5번 다 성공한 과제 수는 조금 더 움직였습니다(LFM2.5 −6, gpt-oss +5). 이 기준으로는 Sonnet(59)이 gemma4 26B(57)를 앞섰는데, 2개 차이라 원래 방식의 60 대 57과 마찬가지로 순위를 가를 만한 차이는 아닙니다. 묻는 모델이 점수에서 손해를 본다는 생각은 이 데이터로는 맞지 않았습니다. Claude 두 모델은 질문으로 끝난 실행이 원래 어려운 과제에 몰려 있었습니다. 그 과제들의 원래 방식 평균 성공률은 Sonnet 53%(나머지 71%), Haiku 32%(나머지 60%)였고, 답을 줘도 결국 틀리는 경우가 많았습니다.
질문을 가장 많이 한 모델은 Claude가 아니었습니다. qwen3.8 27B(322번)와 LFM2.5(256번)가 훨씬 많았고, gemma4 26B는 12번뿐이었습니다. 이 숫자에는 «다른 것도 해 드릴까요?» 같은 제안도 들어 있습니다.
gemma4는 어디서 앞섰나
과제를 주로 쓰는 시스템별로 나눠 보면 모델마다 강한 곳이 다릅니다(평균 성공률, BFCL 원래 방식).
| 주 시스템 | 과제 수 | gemma4 26B | Sonnet 5.5 | LFM2.5 | qwen3.8 | gpt-oss | Haiku 5.5 |
|---|---|---|---|---|---|---|---|
| 주식 거래 | 22 | 75% | 84% | 89% | 86% | 82% | 87% |
| 트위터 비슷한 게시판 | 21 | 67% | 60% | 41% | 49% | 36% | 26% |
| 메시지 | 13 | 83% | 62% | 65% | 68% | 60% | 55% |
| 상담 티켓 | 13 | 49% | 48% | 45% | 54% | 45% | 40% |
| 차량 제어 | 13 | 80% | 72% | 77% | 49% | 48% | 42% |
| 파일 시스템 | 12 | 67% | 65% | 53% | 55% | 25% | 48% |
| 여행 예약 | 6 | 87% | 77% | 83% | 80% | 90% | 63% |
(과제가 여러 시스템을 쓰면 첫 번째 시스템으로 분류. 칸마다 과제 수가 적어 몇 %p 차이는 의미가 크지 않습니다)
gemma4 26B는 주식 거래에서는 가장 낮았지만, 메시지와 게시판 과제에서 크게 앞서 전체 1위가 됐습니다. 게시판 과제 21개는 모두 차량 제어, 파일 시스템, 여행 예약 중 하나와 섞여 있어, 앞 단계 결과를 옮겨 글을 올리는 일이 많습니다.
Sonnet이 이런 과제에서 놓친 기록을 열어 보면, 시킨 것보다 더 해 주려다 틀리는 경우가 있습니다. «document 폴더에 아이디어를 적어 둘 TeamNotes.txt 문서를 만들어 줘»라는 요청에 정답은 빈 파일을 만드는 것인데, Sonnet은 5번 모두 TeamNotes - Fresh Ideas Tracker 제목과 «날짜 | 아이디어 | 제안자 | 상태» 같은 표 머리글(한 번은 «날짜: / 제안자: / 아이디어:» 같은 항목 양식)을 알아서 써 넣었습니다. 사람이라면 고마울 수도 있는 일이지만, 첫 요청이 끝난 시점에 이미 파일 내용이 정답과 달라 실패했습니다. gemma4 26B는 5번 중 4번 빈 파일만 만들었습니다. 이 사례 하나로 전체 차이를 설명할 수는 없고, 이런 종류의 실패가 얼마나 되는지는 세지 않았습니다.
«완료했습니다»라고 말했는데 틀린 경우
실패한 실행을 열어 보면, 모델이 문제를 알리지 않고 «다 했다»고 말한 경우가 있습니다. 예를 들어 gpt-oss 20B는 차량 과제에서 980마일에 약 39갤런이 필요하다고 스스로 계산해 놓고, 26갤런만 채운 뒤 이렇게 답했습니다. "Fuel level: 26 gal (≈ 98 L) in the tank – plenty for the ~980-mile trip"
처음에는 이런 예시를 4개 골라 두었습니다. 그런데 글을 내기 전 검토에서 정답 파일과 다시 맞춰 보니 3개는 제 해석이 틀렸습니다. 사용자가 직접 주가와 거래량의 평균을 요청한 과제였거나, 모델이 말한 «다 채웠다»가 사실이었고 실패 이유는 순서에 있었습니다. 그래서 확인된 하나만 남겼습니다. 겉으로 그럴듯해 보이는 실패 사례도 정답과 대조하지 않으면 믿기 어렵습니다.
이런 «조용한 실패»가 모델마다 얼마나 되는지도 세려고 했지만, 숫자로 내지는 않았습니다. 실패 실행의 마지막 답변을 규칙으로 분류해 보니 손 판정과 맞는 비율이 68%(120건 중 82건)뿐이었습니다. 또 원래 방식 실행 기록에는 답변이 500자까지만 저장돼 뒤에 붙은 경고를 볼 수 없었습니다. 재측정부터는 전체 답변을 저장했습니다.
그래서 어떤 모델을 쓰나
결과를 받아 본 제 생각은 이렇습니다.
현재도 결과에 고민스럽고 이해하려고 하는데, 쉽지 않네요. 클로드가 최고 점수가 안 나오는 점은 의외로 생각합니다. 다양한 작업에 여러 가지 모델을 사용하는 하이브리드 형태의 사용 방법을 찾아야겠어요. gemma4 26B가 왜 1등인지는 아직도 이해가 안 갑니다 ㅋㅋ
위 시스템별 표가 그 하이브리드의 출발점이 될 것 같습니다. 주식 거래처럼 대부분 모델이 잘하는 일은 3090의 작은 모델에 맡기고, 여러 단계 결과를 이어 붙이는 일은 5번 다 성공이 높은 모델을 고르는 식입니다. 이건 이 시험 하나에서 나온 방향이고, 실제 일에서 다시 확인해야 합니다.
한계
- 과제 한 종류, 영어입니다. BFCL 다단계 과제 100개의 결과이고, 다른 에이전트 과제나 한국어 지시에서는 다를 수 있습니다.
- 5번은 많지 않습니다. «5번 다 성공»은 반복을 늘리면 더 내려갑니다.
- 오류도 실패로 셌습니다. Ollama가 모델 응답을 처리하지 못해 오류를 낸 경우(원래 방식: gpt-oss 7번, gemma4 4번, qwen3.8 3번. «시킨 것만»: gpt-oss 8번, gemma4 4번)와 Claude API 연결 오류(원래 방식 Sonnet 2번, «예» 방식 Sonnet 2번과 Haiku 2번)가 실패에 들어 있습니다.
- 질문 감지는 규칙입니다. 정해 둔 표현으로 끝나는 답만 질문으로 봤습니다. 다른 말투로 물으면 놓치고, 질문이 아닌 문장을 잡을 수도 있습니다.
- 설정은 기본값입니다. 로컬 모델은 Ollama 기본 샘플링과 기본 사고 설정, Claude는 확장 사고 없이 돌렸습니다. 모델별로 설정을 다듬으면 결과가 달라질 수 있습니다.
- Claude Opus는 빠졌습니다. 같은 규모로 돌리면 약 $50가 들어 제외했습니다(과제 10개 시범에서는 10개 중 6개 성공).
- 로컬 모델은 4비트(Q4_K_M, gpt-oss는 MXFP4) 양자화 버전입니다.
재현
실행 스크립트(run_bfcl.py, Claude용 run_bfcl_claude.py), 집계와 그림 스크립트, 실행 기록 전체를 재현 파일에 넣었습니다. 원래 방식 3,500건(LFM2.5 온도 두 가지 포함), «시킨 것만» 3,000건, 중단한 «예» 방식 2,295건입니다. BFCL 과제와 채점기는 pip install bfcl-eval==2026.3.23으로 받습니다. 허락 응답은 --confirm-once(«예»)와 --confirm-only(«시킨 것만») 옵션입니다.
다음
새 모델이 «에이전트 성능»을 내세우며 나오면, 이 시험을 한국어 문서 RAG 시험지와 함께 돌려 결과를 올리겠습니다.
관련 글
Same Task, Five Tries: 4 Local LLMs and 2 Claude Models on 100 Multi-Turn Tool-Use Tasks
11월 3일 · 13 min read
AI/MLRTX 3090으로 Claude 대체하기 — Ollama + Caddy 인증 구축기
2월 23일 · 8 min read
Local LLMLocal RAG Scored on 300 Questions: a 27B on One RTX 3090 Tied Claude Opus 5.5, and Most Misses Happened Before the Model
10월 21일 · 18 min read
AI/MLLFM2.5 24B-A2B, 한국어 문서 RAG 300문항으로 채점해 보니: qwen3.8 27B(생각 켬)보다 낮고, gemma4 12B와는 차이가 검출되지 않았다
11월 2일 · 18 min read