LFM2.5 24B-A2B, 한국어 문서 RAG 300문항으로 채점해 보니: qwen3.8 27B(생각 켬)보다 낮고, gemma4 12B와는 차이가 검출되지 않았다
Liquid AI가 10월 12일 공개한 24B MoE(활성 2.4B) 추론 모델 LFM2.5 24B-A2B를 정답이 있는 한국어 문서 RAG 시험지로 채점했습니다. 같은 검색 결과, 같은 지시문, 같은 채점기로(샘플링과 출력 한도는 다름) qwen3.8 27B, gemma4 12B, 카드의 비교 대상 gemma4 26B MoE와 비교했고, GTX 1080 Ti 두 장에서의 속도와 늘 생각하는 모델을 잴 때 주의할 점을 정리했습니다.
이 글의 숫자는 모두 제가 직접 돌려 채점한 값입니다(Claude Opus만 API로 돌림). 시험지와 다른 모델 결과는 「로컬 RAG, 한국어 문서에 정말 맞게 답할까」와 같습니다. (English version: LFM2.5 24B-A2B on a Korean document-QA benchmark)
요약
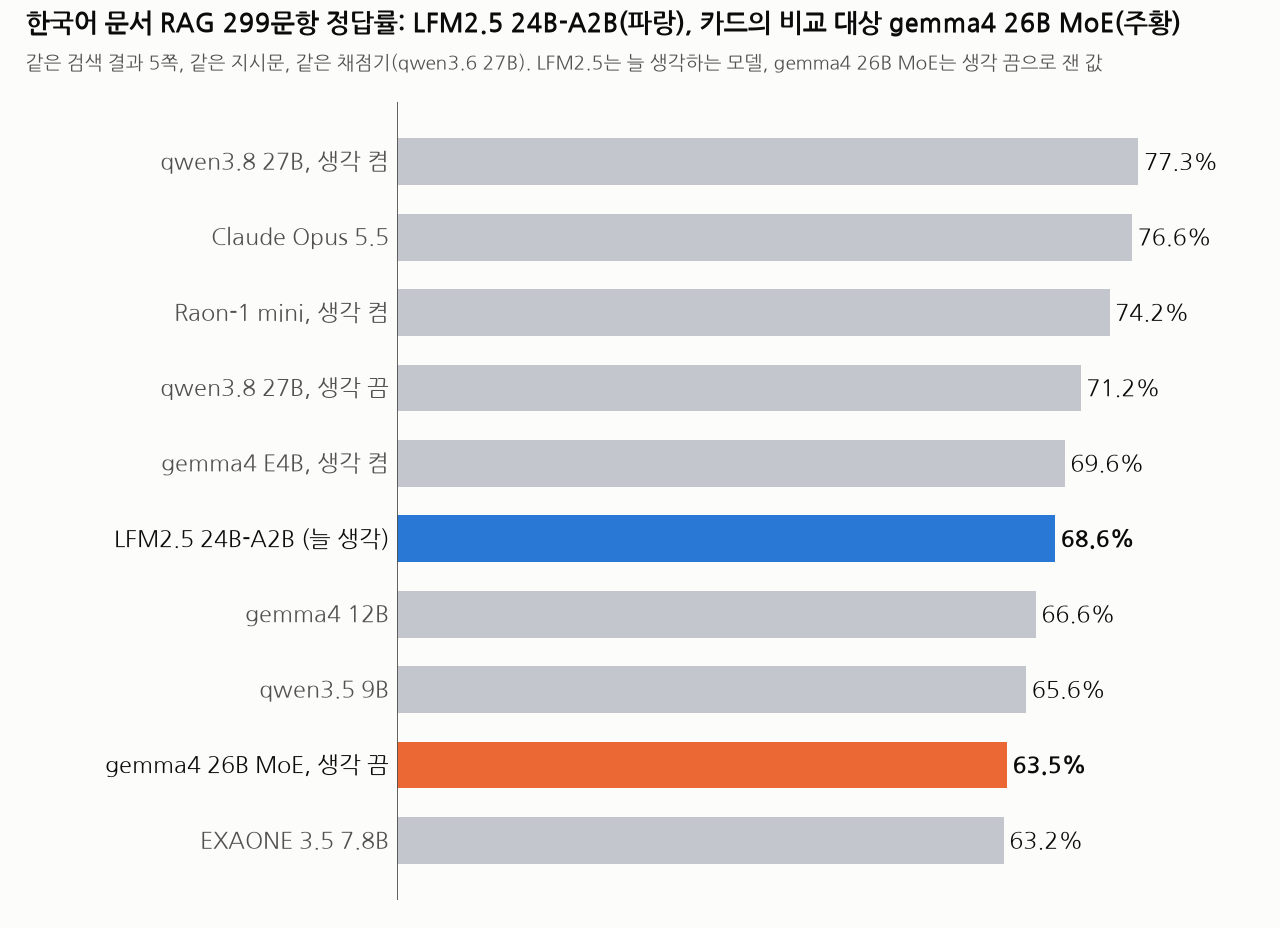
- 정답률(299문항): 68.6%. 이 모델은 늘 생각하고 답하는 추론 모델이라 생각 켬 하나만 쟀습니다.
- 한 번에 쓰는 파라미터가 2.4B인 MoE인데, gemma4 12B(66.6%), qwen3.5 9B(65.6%)와 차이가 검출되지 않았습니다. 생각을 켠 gemma4 E4B(69.6%), qwen3.8 27B 생각 끔(71.2%)과도 차이가 검출되지 않았습니다. 65~71% 구간에 여러 모델이 몰려 있습니다.
- qwen3.8 27B(생각 켬 77.3%)보다는 낮습니다(LFM만 맞힌 문항 11개, qwen만 맞힌 문항 37개, p 0.001 미만).
- 카드의 비교 대상 gemma4 26B MoE와는 같은 조건으로 비교하지 못했습니다. 생각 끔으로 잰 gemma4 26B MoE(63.5%)보다 높게 나왔지만(29 / 14, 보정 전 p=0.03), LFM2.5는 생각을 하고 gemma는 하지 않은 비교라 우열로 읽을 수 없습니다.
- 14.5GB 파일이 GTX 1080 Ti(11GB) 두 장에 다 올라갑니다. 생성은 초당 약 24토큰인데, 생각이 길어서(중앙값 약 1,940토큰) 문항당 85초가 걸렸습니다.
- 지난번 Nanbeige4.3 측정 뒤 고친 측정 도구로 잰 첫 모델입니다. 출력 한도(20,480토큰)에 걸린 답과 빈 답은 0개였습니다.
LFM2.5 24B-A2B가 뭔가
Liquid AI가 2026년 10월 12일 Hugging Face에 올린 모델입니다(모델 카드).
- 전체 240억 파라미터, 토큰마다 쓰는 파라미터는 약 24억(2.45B)인 MoE입니다. 전문가 64개 중 4개를 고르고, 40층 중 30층은 짧은 합성곱, 10층은 어텐션입니다.
- 카드는 **「늘 생각하고 답하는 추론 모델」**이라고 적었습니다. 실제로 Ollama에서 생각 끔을 걸어도 생각을 했습니다.
- 내세우는 쓰임새는 기기 안에서 도는 빠른 에이전트(추론, 도구 호출)입니다. 카드의 벤치마크도 지식, 지시 따르기, 수학, 코딩, 도구 호출, 에이전트 작업이고, 비교 대상은 Qwen3.6 35B-A3B, Gemma 4 26B-A4B, Nemotron 3.5 Lightning입니다. 한국어 벤치마크는 없고, 문서를 근거로 답하는 RAG 시험도 따로 없습니다(검색을 쓰는 에이전트 과제는 있습니다).
- 카드의 언어 목록 16개에 한국어가 들어 있습니다.
- 카드는 이렇게 적었습니다: 「지식 위주 과제에는 단독으로 권장하지 않습니다. 검색이나 웹 검색과 함께 쓰세요.」(원문: "It is not recommended for knowledge-heavy tasks on its own: pair it with retrieval or web search") 카드는 이어서 그게 도구 호출 능력을 살리는 방식이라고 적었습니다. 이 시험지는 검색 결과를 프롬프트에 넣어 주는 방식이라, 카드가 권하는 쓰임새에 가깝지만 똑같지는 않습니다.
- 라이선스는 Liquid AI의 자체 라이선스(LFM 1.0)입니다.
측정 조건
| 항목 | 내용 |
|---|---|
| 시험지 | Allganize 한국어 RAG 평가 데이터 300문항(금융, 공공, 의료, 법률, 커머스). 근거 페이지 번호가 빈 1문항을 뺀 299문항과, 제가 만든 「문서에 답 없는 질문」 20개 |
| 검색 | 도메인 문서 전체에서 하이브리드(kiwi 형태소 BM25 + bge-m3) 상위 5쪽. 모든 모델이 같은 5쪽을 받음 |
| 지시문 | 「발췌만 근거로 답하고, 없으면 찾을 수 없다고 하라」 |
| 모델 | Liquid AI 공식 Q4_K_M GGUF(14.5GB) |
| 실행 | Ollama 0.40.5, GTX 1080 Ti 두 장(PD 서버, 모델 전체가 GPU에 올라감), 문맥 32,768 |
| 샘플링 | 카드 권장값: 온도 0.1, top_k 50, repeat_penalty 1.05, seed 42 |
| 출력 한도 | 20,480토큰(생각 포함) |
| 채점 | qwen3.6 27B(첫 글에서 Allganize 판정과 88.5% 일치 검증) |
다른 모델과 다른 점이 두 가지 있습니다. 다른 로컬 모델은 온도 0으로 돌렸고 출력 한도는 생각 끔 1,024, 생각 켬 8,192였습니다. 이 모델은 카드 권장 샘플링으로 돌렸고, 늘 생각하므로 출력 한도를 20,480으로 잡았습니다. Nanbeige4.3에서 생각이 긴 모델을 온도 0, 한도 8,192로 돌렸다가 한도에 걸린 답을 오답으로 센 실수가 있었기 때문입니다. 20,480 한도에 걸린 답은 0개였고, 8,192를 넘긴 답은 7개였는데 그중 맞은 건 1개뿐이라, 예전 한도였어도 점수 차이는 1문항 이내였을 겁니다. 비교 대상 중 qwen3.8 27B, gemma4 E4B, Nemotron Bolt(모두 생각 켬)는 8,192 한도에 걸린 답이 0개라, 한도 차이가 이 비교에는 영향을 주지 않습니다. 예외는 Raon-1 mini입니다(아래).
결과
| 조건 | 정답률 | 검색이 맞았을 때 | 문단 | 텍스트 | 표 | 이미지 |
|---|---|---|---|---|---|---|
| qwen3.8 27B, 생각 켬 | 77.3% | 90.1% | 87% | 84% | 80% | 44% |
| LFM2.5 24B-A2B | 68.6% | 79.4% | 82% | 64% | 72% | 33% |
| gemma4 12B | 66.6% | 77.4% | 84% | 62% | 58% | 32% |
| gemma4 26B MoE, 생각 끔 | 63.5% | 74.5% | 78% | 67% | 56% | 30% |
문항 수는 문단 147, 텍스트 45, 표 50, 이미지 57이고, 「검색이 맞았을 때」는 근거 페이지가 상위 5쪽에 들어온 243문항입니다. 문서에 답이 없는 20문항 중 19개를 「찾을 수 없다」고 답했습니다. 놓친 1개는 외국인 지분 한도를 묻는 질문에 발췌 속 다른 항목(지방은행의 비금융주력자 주식 보유 한도 15%)을 답으로 가져온 경우였습니다.
같은 문항으로 짝지어 비교(McNemar 정확 검정, 299문항. 「A만」은 LFM2.5만 맞히고 비교 모델은 틀린 문항 수)
| 비교 | LFM만 / 비교 모델만 (p) |
|---|---|
| qwen3.8 27B, 생각 켬 (77.3%) | 11 / 37 (0.001 미만) |
| Claude Opus 5.5 (76.6%) | 12 / 36 (0.001 미만) |
| Raon-1 mini, 생각 켬 (74.2%) | 12 / 29 (0.012) |
| qwen3.8 27B, 생각 끔 (71.2%) | 19 / 27 (0.30) |
| gemma4 E4B, 생각 켬 (69.6%) | 19 / 22 (0.76) |
| gemma4 12B (66.6%) | 20 / 14 (0.39) |
| Nanbeige4.3 33B, 생각 켬, 한도에 걸린 29문항 다시 돌림 (70.6%) | 20 / 26 (0.46) |
| Nemotron 3.5 Bolt E4B, 생각 켬 (67.2%) | 22 / 18 (0.64) |
| qwen3.5 9B (65.6%) | 29 / 20 (0.25) |
| gemma4 26B MoE, 생각 끔 (63.5%) | 29 / 14 (0.032) |
| EXAONE 3.5 7.8B (63.2%) | 32 / 16 (0.029) |
읽는 법:
- qwen3.8 27B(생각 켬)와 Claude Opus 5.5보다는 낮습니다. 비교 11개를 다중 비교로 보정해도 유의합니다.
- Raon-1 mini(생각 켬)보다도 낮게 나왔지만(p=0.012), 보정하면 유의하지 않습니다. 다만 Raon-1 mini는 생각 켬에서 16문항이 한도 8,192에 걸렸는데 다시 돌리지 않았으니, 실제 차이는 더 클 수 있습니다.
- qwen3.8 27B 생각 끔부터 qwen3.5 9B까지는 차이가 검출되지 않았습니다. 이 구간(65~71%)은 이 시험지 크기로는 순위를 가르기 어렵습니다.
- gemma4 26B MoE와 EXAONE 3.5 7.8B보다는 높게 나왔지만, 보정하면 유의하지 않습니다. p 0.03 안팎이고, 비교 11개를 다중 비교 보정 없이 한 결과입니다. 또 gemma4 26B MoE는 생각 끔으로 쟀고, LFM2.5는 늘 생각합니다. 생각을 켠 gemma4 26B MoE와 비교한 것은 아닙니다.
- 표 문항(72%)이 gemma4 12B(58%), gemma4 26B MoE(56%)보다 높은 게 눈에 띕니다. 50문항뿐이라 참고만 하세요.
늘 생각하는 모델을 잴 때 본 것
생각은 영어로, 답은 한국어로 합니다. 320개 생각 중 318개가 「We need…」로 시작했고(나머지 2개는 「We have a user…」), 무작위로 고른 20개 모두 생각의 본문 문장은 영어였습니다(발췌 인용과 답 초안은 한국어). 답은 모두 한국어였습니다. 생각에 한자나 가나가 섞인 경우가 27개 있었습니다. 16개는 문서에 있던 한자를 옮긴 것이고, 11개에는 프롬프트에 없는 중국어나 일본어 단어(现场, 実績 등)를 모델이 직접 썼습니다. 모델이 만든 이런 단어는 답에 나오지 않았습니다(문서의 한자를 그대로 옮긴 답은 3개).
생각과 답이 어긋난 경우가 있었습니다. 아래 두 사례는 하나씩 열어 보다 찾은 것이고, 이런 어긋남이 전체에서 몇 번 일어났는지는 세지 않았습니다. 한 문항은 생각 끝에서 답을 「갑상선암, 10만 명당 100명」으로 정해 놓고, 실제 답은 「문서에서 찾을 수 없습니다」라고 썼습니다. 다른 한 문항은 8,500토큰 동안 생각한 끝에 「한도는 개인 15억(또는 30억?)」이라고 적어 놓고, 답에는 스스로 물음표를 붙였던 30억을 사실처럼 썼습니다.
반복 경고는 이번에는 문제를 가리키지 않았습니다. Nanbeige 뒤에 측정 도구에 넣은 「같은 줄이 세 번 이상 나오면 경고」가 규칙대로 12개를 잡았지만, 찾으려던 것(한도까지 가는 반복 고리)은 아니었습니다. 하나씩 열어 보니 전부 생각 쪽이었고, 모두 스스로 끝냈고(한도 전에 멈춤), 형식이 정상인 답을 냈습니다(12개 중 2개는 오답). 답 초안을 쓰고, 발췌와 대조하고, 같은 초안을 다시 붙이는 식의 되새김이었습니다. 「Thus answer accordingly.」를 세 번 쓴 생각도 4개 있었습니다. Nanbeige에서 본 것처럼 같은 문장을 수십 번 되풀이하다 한도에 잘리는 고리는 한 건도 없었습니다. 다만 Nanbeige는 온도 0에 반복 억제 없이 돌렸고 이 모델은 카드 권장대로 repeat_penalty 1.05를 걸었으니, 모델 차이인지 설정 차이인지는 가르지 못합니다. 경고는 한도까지 가는 고리만 잡도록 고칠 생각입니다.
속도: GTX 1080 Ti 두 장
| 값 | |
|---|---|
| 생성 | 초당 약 24토큰 |
| 프롬프트 처리 | 초당 약 1,080토큰 |
| 생성 토큰 중앙값(생각 포함) | 약 1,940토큰 |
| 문항당(320문항 본 측정 중앙값) | 85초 |
| GPU 메모리 | 문맥 32k에서 Ollama가 보고한 크기 약 16.2GB(두 장에 나뉨, 측정 전 확인) |
- 활성 2.4B라 토큰 하나는 빠르지만, 생각을 길게 해서 문항당 시간은 깁니다. 같은 1080 Ti 두 장에서 qwen3.8 27B 생각 끔은 문항당 31초였습니다. 정답률 차이도 검출되지 않았으니(71.2%, p=0.30), 이 장비에서 한국어 문서 질의응답만 놓고 보면, qwen3.8 27B 생각 끔은 3분의 1 시간에 차이가 검출되지 않는 결과를 냅니다.
- 측정 도구의 30문항 속도 측정(생각 끔 설정, 출력 한도 1,024)은 문항당 45초로 나왔는데, 이 모델은 생각 끔이 안 돼서 30문항 중 25개가 1,024토큰에서 잘렸습니다. 그래서 위 표는 320문항 본 측정 값을 썼습니다. 생성 속도(초당 24토큰)와 프롬프트 처리 속도는 두 측정이 같았습니다.
- RTX 3090에서는 재지 않았습니다.
한계
- 한 번씩만 돌렸습니다. 65
71% 구간의 23%p 차이는 순위로 읽지 마세요. 이 모델은 온도 0.1로 샘플링했으니 다시 돌리면 문항별 판정이 일부 바뀝니다. p가 0.01~0.03인 비교는 그만큼 흔들릴 수 있습니다. - 다른 로컬 모델은 온도 0(한도는 생각 끔 1,024, 생각 켬 8,192)으로 쟀고, 이 모델은 카드 권장 샘플링, 한도 20,480으로 쟀습니다. 같은 시험지에서 온도 0과 카드 설정을 비교했을 때 Raon-1 mini(생각 켬)와 Nanbeige4.3(생각 끔)은 정답 수가 2문항 차이였습니다. 다만 문항별 판정은 각각 12개, 34개가 바뀌었습니다.
- gemma4 26B MoE는 생각 끔으로 잰 값입니다. 카드가 어떤 조건으로 비교했는지는 확인하지 못했습니다.
- 채점은 LLM 하나(qwen3.6 27B)가 했습니다. 채점기는 생각을 뺀 최종 답만 봤습니다. 이번에는 두 번째 채점기를 쓰지 않았고, 사람이 전부 확인하지도 않았습니다. 채점기가 가장 높은 비교 모델(qwen3.8)과 같은 계열이라는 점도 감안하세요. 첫 글에서는 다른 계열 채점기(Claude Opus)로 다시 채점해 결론이 같았습니다.
- Q4_K_M 하나만 썼습니다.
- 카드의 주 비교 대상인 Qwen3.6 35B-A3B는 재지 않았습니다.
- 한국어 공공 문서 시험지 하나의 결과입니다. 카드가 내세운 도구 호출과 에이전트 작업은 재지 않았습니다. 「한국어 문서에서 근거로 답하기」에 한정한 결론입니다.
재현
생성, 채점 스크립트와 문항별 판정은 첫 글의 재현 파일에 추가했습니다. 측정은 measure.sh(옵션 --think-only --ctx 32768 --np-think 20480 --temp 0.1 --top-k 50 --repeat-penalty 1.05), 그림은 figs_lfm.py입니다.
다음에 읽을 글
- 한국어 문서 RAG 리더보드: 이 시험지로 채점한 모든 모델과 조건을 한 표로 모은 페이지
- Nanbeige4.3 33B, 한국어 문서 RAG 300문항으로 채점해 보니: 출력 한도에 걸린 답을 다시 잰 과정과, 측정 도구를 고친 계기
- 로컬 RAG, 한국어 문서에 정말 맞게 답할까 (300문항 채점): 이 글의 시험지와 qwen3.8 27B, gemma4 결과
- 크래프톤 Raon-1 mini, 한국어 문서 RAG 300문항으로 채점해 보니: 같은 시험지로 잰 국산 MoE
관련 글
LFM2.5 24B-A2B on a Korean Document-QA Benchmark: Below qwen3.8 27B (Thinking), No Detectable Gap to gemma4 12B
11월 2일 · 11 min read
AI/ML엔비디아 Nemotron 3.5 Bolt E4B, 한국어 문서 RAG 300문항으로 채점해 보니: 바탕 모델 gemma4 E4B와 같은 조건 비교
10월 26일 · 17 min read
AI/ML크래프톤 Raon-1 mini, 한국어 문서 RAG 300문항으로 채점해 보니: 3090 한 장·1080 Ti 두 장에서 돌린 결과
10월 22일 · 18 min read
AI/MLNanbeige4.3 33B, 한국어 문서 RAG 300문항으로 채점해 보니: 모델 카드에서 qwen3.8 27B를 앞선 모델, 같은 조건으로 비교
10월 28일 · 25 min read