로컬 RAG, 한국어 문서에 정말 맞게 답할까 — 정답 있는 300문항으로 채점해 보니 로컬 27B가 Opus 5.5와 비겼고, 남은 점수는 파싱과 검색에서 샜다
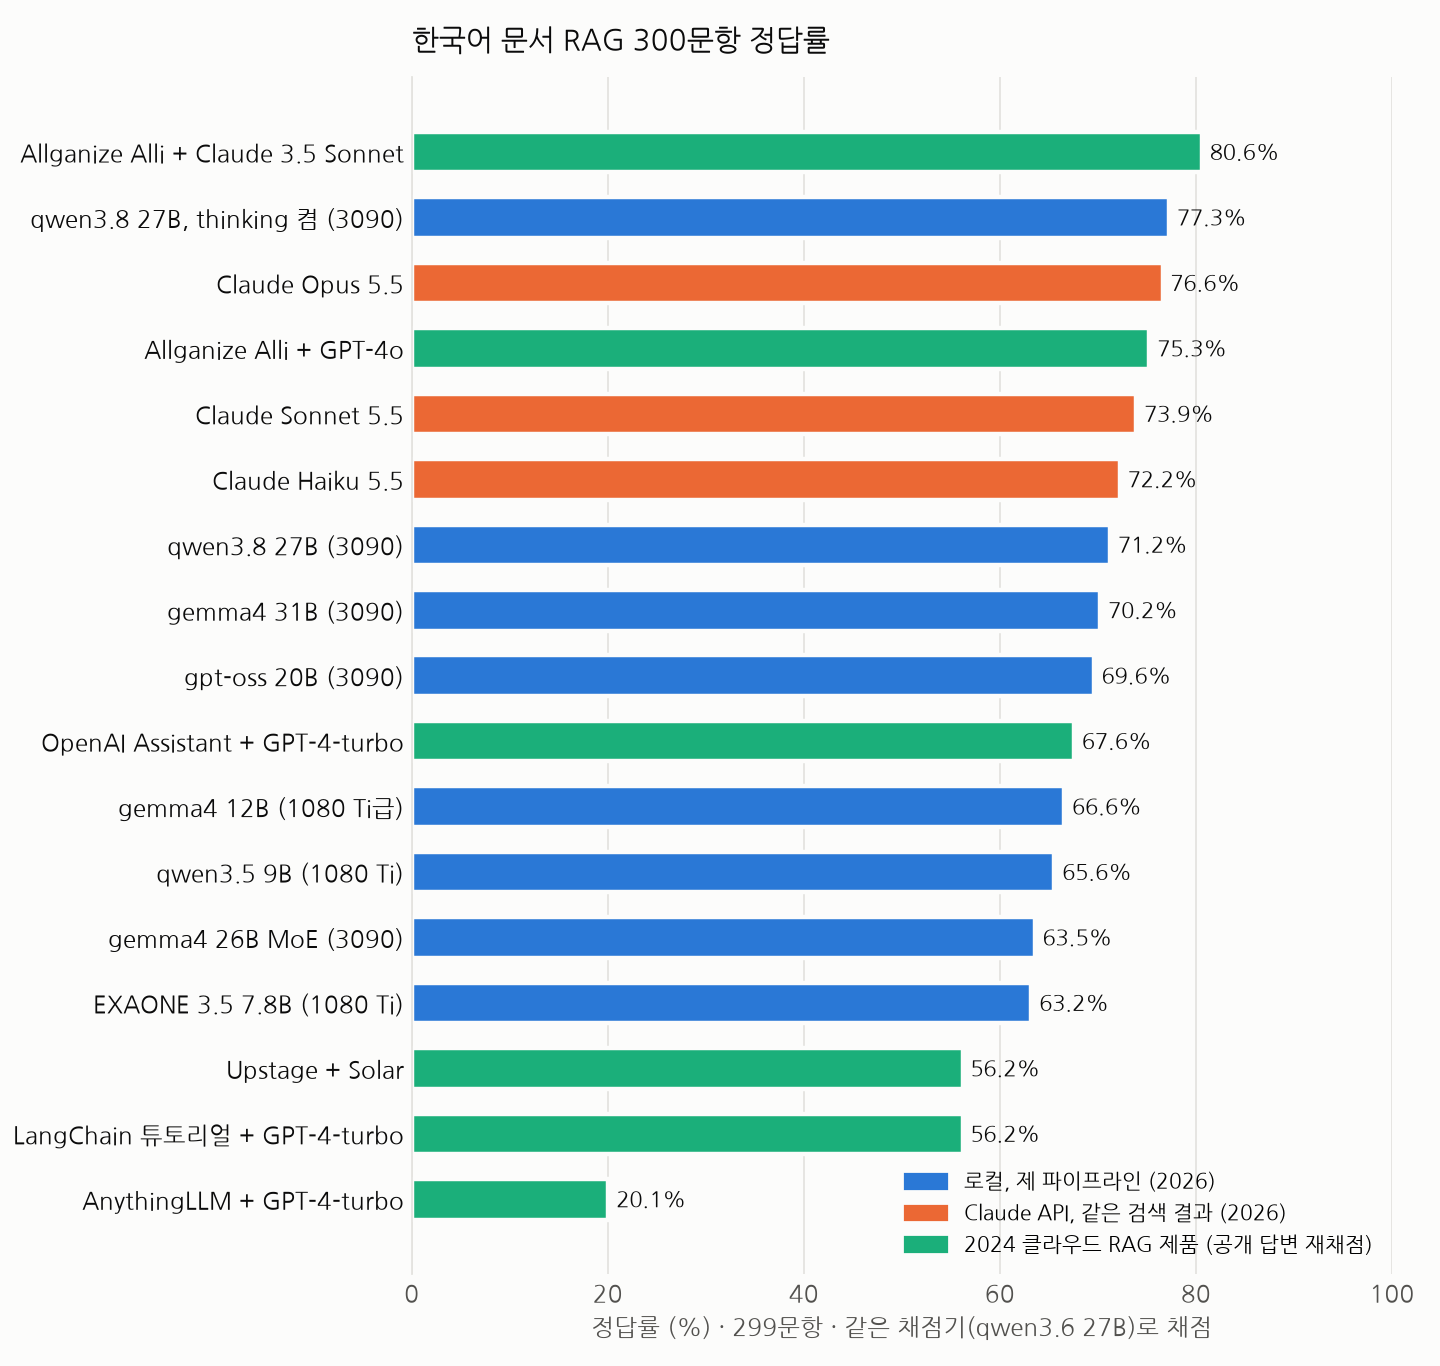
공개된 한국어 RAG 시험지 300문항으로 로컬 모델 7종과 Claude 5.5 세 모델을 같은 검색 결과 위에서 채점했습니다. 3090 한 장의 qwen3.8 27B는 thinking을 켜면 채점기 두 개 모두에서 Opus 5.5와 구분되지 않았고, 상위 모델이 틀린 문항의 약 3분의 2는 생성이 아니라 PDF 파싱과 검색 단계에서 근거를 놓친 문항이었습니다.
이 글의 숫자는 전부 제 서버에서 직접 돌려 채점한 값이고, 문항별 판정은 재현 파일의
verdicts.csv에 그대로 들어 있습니다. 시험지는 Allganize가 공개한 한국어 RAG 평가 데이터(MIT 라이선스)입니다. 실행 전에 예측 6개를 먼저 적어 두었고, 틀린 예측도 그대로 적었습니다. 초안을 별도 검토자에게 원자료로 다시 계산하게 해서 나온 지적도 반영했습니다. (영문판: Local RAG Scored on 300 Questions)
요약
- 같은 검색 결과를 넣으면, RTX 3090 한 장의 qwen3.8 27B(thinking 켬)가 Claude Opus 5.5와 구분되지 않았습니다. 주 채점기 기준 77.3% 대 76.6%(p=0.82), 다른 계열의 두 번째 채점기(Opus 5.5) 기준 80.6% 대 80.3%(p=1.0)입니다. thinking을 끄면 두 채점기 모두에서 Opus보다 확실히 낮았습니다.
- 상위 모델이 틀린 문항의 약 3분의 2는 생성 단계 전에 이미 틀린 문항입니다. Opus 5.5가 틀린 70문항은 PDF에 텍스트 층이 없는 페이지 22개, 검색 순위에서 근거 페이지를 놓친 23개, 근거를 받고도 틀린 25개로 나뉩니다.
- 키워드 검색(BM25)을 띄어쓰기 대신 형태소(kiwi)로 자르는 것만으로 검색 적중률이 56% → 80%로 올랐습니다. 바꾼 건 토큰화 함수 하나입니다.
- 2024년 Allganize 상용 파이프라인 + Claude 3.5 Sonnet(80.6%)과 제 파이프라인 + Opus 5.5(76.6%)의 차이는 전부 「텍스트 층이 없는 페이지」에서 나왔습니다. 그런 23문항에서 Alli는 19개, Opus는 1개를 맞혔습니다. 글자가 있는 페이지만 보면 Opus 쪽이 오히려 조금 많이 맞혔습니다(31 대 25, 유의하지 않음). 2년 새 바뀐 모델 세대보다 OCR 하나가 컸습니다.
- 1080 Ti 한 장의 qwen3.5 9B + 제 파이프라인(65.6%)은 2024년 LangChain 기본 튜토리얼 + GPT-4-turbo(56.2%)보다 높았습니다(p=0.003).
- 문서에 답이 없는 질문 20개에는 7.8B부터 Opus까지 모든 모델이 20개 전부 「찾을 수 없다」고 답했습니다. 작은 모델이 지어낼 거라는 제 예측은 틀렸고, 이 20문항은 모델을 가를 만큼 어렵지 않았습니다.
왜 이 실험을 했나
로컬 LLM으로 RAG를 만드는 글은 많습니다. 대부분은 「Ollama에 문서를 넣었더니 그럴듯하게 답하더라」로 끝납니다. 그럴듯한 답과 맞는 답은 다릅니다. 그래서 정답이 있는 질문으로 채점하기로 했습니다. 사내 문서·의료·법률처럼 문서를 밖으로 보낼 수 없는 사람에게 필요한 질문은 「로컬로 충분한가, 어디서 깨지나」이고, 이건 점수로만 답할 수 있습니다.
측정 환경
| 항목 | 내용 |
|---|---|
| 시험지 | allganize/RAG-Evaluation-Dataset-KO (MIT) — 금융·공공·의료·법률·커머스 각 60문항. 문항마다 정답·근거 페이지·근거 유형(문단·텍스트·표·이미지) |
| 원문 PDF | 기관 사이트 직접 다운로드는 64개 중 21개만 성공(나머지는 게시판 페이지 링크). 페이지 단위 미러 datalama/RAG-Evaluation-Dataset-KO(MIT, 64개 문서 1,450쪽)를 쓰고, 직접 받은 21개와 본문이 같은지 대조(머리글 한 줄 차이 외 동일) |
| 채점 대상 | 근거 페이지 번호가 비어 있는 1문항을 뺀 299문항 + 제가 만든 「답 없는 질문」 20개 |
| 파싱 | PyMuPDF, pypdf, pymupdf4llm(표를 마크다운으로) 세 가지 비교 → 생성에는 pymupdf4llm. OCR은 하지 않음 |
| 검색 | 도메인별 문서 전체에서 페이지 단위 검색. BM25(띄어쓰기 / kiwi 형태소), bge-m3 임베딩, 둘을 섞은 하이브리드(RRF) → 생성에는 하이브리드 상위 5쪽 |
| 생성 (공통) | 모든 모델에 같은 5쪽, 같은 지시문(「발췌에 없으면 찾을 수 없다고 하라」 포함) |
| 생성 (로컬) | Ollama, temperature 0, 출력 한도 1,024토큰, thinking 끔. 「thinking 켬」 줄과 gpt-oss(끌 수 없음)는 출력 한도 8,192토큰 |
| 생성 (Claude) | Opus 5.5, Sonnet 5.5, Haiku 5.5 — API, effort medium, 출력 한도 16,000토큰, 기본 샘플링, 자동 대체(fallback) 끔. Opus 5.5는 thinking을 끌 수 없어서 세 모델 모두 기본값(adaptive thinking)으로 맞춤 |
| 로컬 GPU | GTX 1080 Ti 11GB × 2 (WSL2), RTX 3090 24GB (별도 PC) |
| Ollama | 1080 Ti 0.30.2 / 0.40.5, 3090 0.40.2 |
| 채점기 | 주 채점기 qwen3.6 27B(3090), 두 번째 채점기 Claude Opus 5.5. 같은 프롬프트로 정답과 비교해 O/X |
채점기를 먼저 검증했습니다
LLM이 채점하면 채점기가 틀릴 수 있습니다. 이 시험지에는 2024년 클라우드 RAG 제품들의 답변 원문과 Allganize의 O/X 판정이 함께 들어 있어서, 제 채점기를 거기에 맞춰 볼 수 있었습니다. 452개 답변에서 일치율 88.5%, 코헨 카파 0.76이었고, 제 채점기가 O를 약 4%p 덜 줬습니다(더 엄격). Allganize는 자기 자동 채점이 사람 판정과 약 8% 어긋났다고 적어 두었습니다(금융 도메인 기준).
그래서 2024년 클라우드 점수는 공개된 숫자를 그대로 쓰지 않고, 공개된 답변 원문을 제 채점기로 다시 매긴 값으로 비교했습니다. 다시 매긴 8개 시스템 모두 공개 숫자보다 3~10%p 낮게 나왔습니다. 아래 표에 넣은 6개 시스템의 순서는 그대로였고(Upstage와 LangChain은 동률이 됨), 표에 넣지 않은 Alli + KONI-8B는 5위에서 7위로 내려갔습니다.
채점기 자기편향도 확인했습니다. 주 채점기(qwen3.6)와 이번 1위(qwen3.8)가 같은 계열이라, 다른 계열인 Opus 5.5로 모든 답을 한 번 더 채점했습니다. 두 채점기의 판정 일치율은 조합별 9297%였습니다. Opus 채점기는 전반적으로 더 후했는데, 특히 Claude 답변에 46%p를 더 줬습니다(로컬 답변에는 -2~+5%p). 결론은 두 채점기에서 같았습니다.
실행 전에 적어 둔 예측과 결과
| # | 예측 (실행 전) | 결과 | |
|---|---|---|---|
| 1 | BM25를 형태소로 자르면 hit@5가 10%p 이상 오른다 | 56.2% → 80.3% (+24.1%p) | ✅ |
| 2 | 이미지 근거 문항의 검색 적중률이 가장 낮다 | 네 방식 모두 이미지가 최저 (하이브리드: 이미지 54%, 문단 88%, 표 84%, 텍스트 89%) | ✅ |
| 3 | 하이브리드가 각 단독보다 hit@5가 높다 | 81.3% vs 형태소 80.3% vs 임베딩 77.3%. 차이는 3문항이고, hit@3에서는 형태소 단독(78.6%)이 하이브리드(77.9%)보다 높음 | △ |
| 4 | 검색이 맞으면 7~12B는 70% 이상, 27B급은 클라우드(GPT-4o급, 재채점)와 5%p 이내 | 7.8B 72.8%, 9B 76.5%, 12B 77.4% / qwen3.8 27B(thinking 끔) 71.2%는 Alli+GPT-4o 75.3%와 4.1%p 차이지만, gemma4 31B는 5.1%p, gemma4 26B MoE는 11.8%p 차이 | ✅ / △ |
| 5 | 로컬 최고 조합은 공개표의 Alli+GPT-4o(0.783)보다 낮고 LangChain+GPT-4-turbo(0.61)보다 높다 | 같은 채점기로 맞추면 thinking 켠 qwen3.8 27B 77.3%가 Alli+GPT-4o 75.3%보다 높음(차이는 유의하지 않음, p=0.58). 공개 숫자(다른 채점기)와 직접 비교하면 맞지만 공정한 비교가 아님 | ❌ |
| 6 | 답 없는 질문에 7~12B 절반 이상이 답을 지어낸다 | 모든 모델 0/20 | ❌ |
예측 6은 완전히 틀렸습니다. 작은 모델이 지어낼 거라는 선입견이 있었는데, 「없으면 찾을 수 없다고 하라」는 지시를 주자 7.8B도 20개 모두 지켰습니다.
1. 검색: 띄어쓰기 대신 형태소로 자르면 +24%p
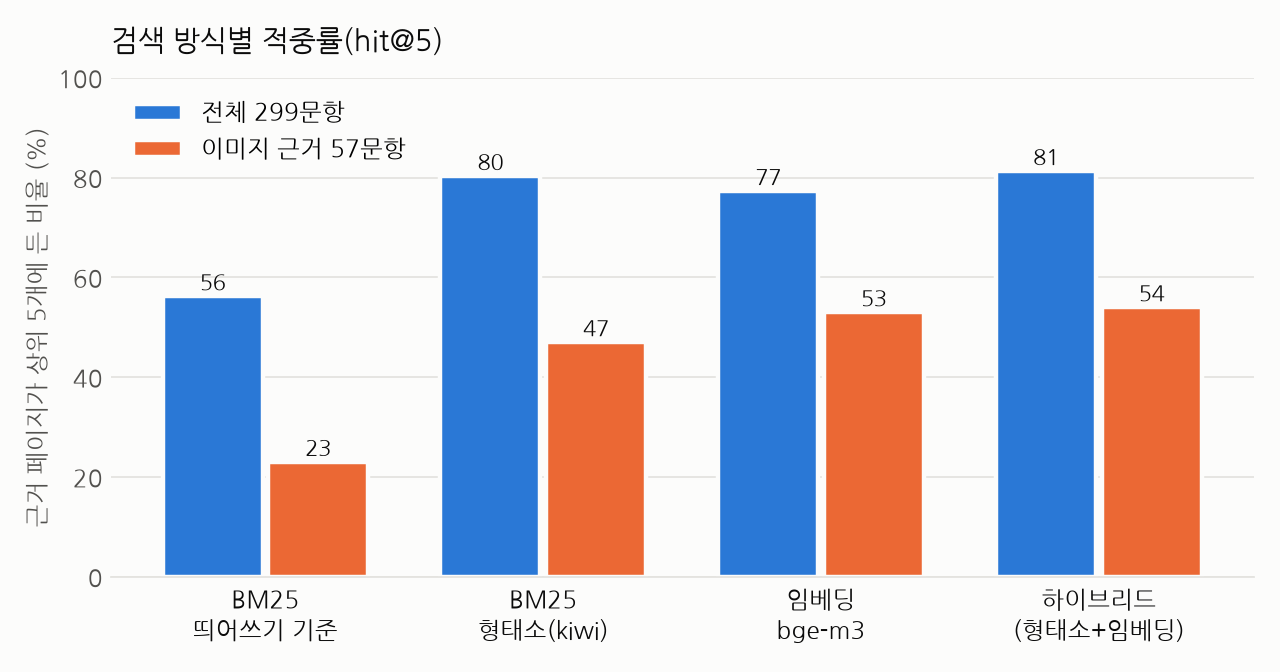
| 검색 방식 (pymupdf4llm 텍스트) | hit@1 | hit@3 | hit@5 | hit@10 |
|---|---|---|---|---|
| BM25, 띄어쓰기 기준 | 37.1% | 49.5% | 56.2% | 59.5% |
| BM25, kiwi 형태소 | 61.9% | 78.6% | 80.3% | 82.6% |
| bge-m3 임베딩 | 54.2% | 71.9% | 77.3% | 80.9% |
| 하이브리드 (형태소 + 임베딩, RRF) | 61.9% | 77.9% | 81.3% | 82.9% |
한국어는 조사가 단어에 붙습니다. 「은행법」, 「은행법에」, 「은행법상」을 띄어쓰기로 자르면 전부 다른 단어가 됩니다. 영어 문서용 BM25 예제를 그대로 가져오면 이렇게 됩니다. 형태소 분석기 kiwi로 명사·동사·형용사 어간과 숫자·영문만 남기니 단독으로도 임베딩 검색보다 높았습니다.
from kiwipiepy import Kiwi
kiwi = Kiwi()
KEEP = ('NN', 'VV', 'VA', 'SL', 'SN', 'XR', 'SH', 'MM')
def tok_kiwi(s):
    return [t.form.lower() for t in kiwi.tokenize(s) if t.tag.startswith(KEEP)]
# BM25Okapi([tok_kiwi(page) for page in pages]) 로 바꾸기만 하면 됩니다
파서 차이는 작았습니다. 하이브리드 hit@5 기준 PyMuPDF 81.3%, pymupdf4llm 81.3%, pypdf 77.9%입니다.
2. 생성: 같은 5쪽을 넣고 모델만 바꾸면
| 모델 (실행 위치) | 전체 | 두 번째 채점기 | 검색이 맞았을 때 | 문단 | 텍스트 | 표 | 이미지 |
|---|---|---|---|---|---|---|---|
| qwen3.8 27B, thinking 켬 (3090) | 77.3% | 80.6% | 90.1% | 87% | 84% | 80% | 44% |
| Claude Opus 5.5 | 76.6% | 80.3% | 89.7% | 85% | 84% | 80% | 46% |
| Claude Sonnet 5.5 | 73.9% | 79.3% | 86.0% | 83% | 78% | 82% | 40% |
| Claude Haiku 5.5 | 72.2% | 78.3% | 85.6% | 83% | 73% | 76% | 40% |
| qwen3.8 27B (3090) | 71.2% | 72.2% | 84.0% | 85% | 76% | 68% | 35% |
| gemma4 31B (3090) | 70.2% | 72.9% | 81.5% | 84% | 78% | 66% | 33% |
| gpt-oss 20B (3090)** | 69.6% | 71.6% | 79.4% | 82% | 80% | 70% | 30% |
| gemma4 12B (1080 Ti급)* | 66.6% | 68.2% | 77.4% | 84% | 62% | 58% | 32% |
| qwen3.5 9B (1080 Ti) | 65.6% | 66.9% | 76.5% | 84% | 64% | 52% | 32% |
| gemma4 26B MoE (3090) | 63.5% | 68.9% | 74.5% | 78% | 67% | 56% | 30% |
| EXAONE 3.5 7.8B (1080 Ti) | 63.2% | 61.5% | 72.8% | 81% | 60% | 50% | 32% |
「전체」와 유형별 칸은 주 채점기(qwen3.6 27B), 「두 번째 채점기」는 Opus 5.5 기준입니다. 문항 수는 문단 147, 텍스트 45, 표 50, 이미지 57입니다. 「검색이 맞았을 때」는 근거 페이지가 상위 5쪽에 들어온 243문항입니다. *gemma4 12B는 1080 Ti 쪽 Ollama 0.30.2가 이 모델을 올리지 못해(8번 함정) 답변 생성은 3090에서 했습니다. 정답률은 장비와 무관하고, 1080 Ti 속도는 7번에서 따로 쟀습니다. **gpt-oss는 생각(reasoning)을 끌 수 없어 기본 설정으로 돌렸고, 출력 한도 8,192토큰으로 다시 돌린 결과입니다(8번 함정).
같은 문항을 두고 짝지어 비교한 결과(McNemar 정확 검정, 299문항)
| 비교 | 채점기 | A만 맞힘 | B만 맞힘 | p |
|---|---|---|---|---|
| qwen3.8 thinking 켬 vs Opus 5.5 | 주 | 10 | 8 | 0.82 |
| 〃 | 두 번째 | 5 | 4 | 1.0 |
| qwen3.8 thinking 켬 vs 끔 | 주 | 25 | 7 | 0.002 |
| 〃 | 두 번째 | 28 | 3 | 0.001 미만 |
| Opus 5.5 vs qwen3.8 thinking 끔 | 주 | 25 | 9 | 0.009 |
| 〃 | 두 번째 | 28 | 4 | 0.001 미만 |
| qwen3.8 thinking 켬 vs Sonnet 5.5 | 주 | 15 | 5 | 0.04 |
| Opus 5.5 vs Sonnet 5.5 | 주 | 12 | 4 | 0.08 |
읽는 법: thinking을 켠 qwen3.8과 Opus는 서로 다른 문항을 몇 개씩 맞혔을 뿐, 어느 채점기로 봐도 우열이 없습니다. thinking은 qwen3.8에서 확실한 이득이었고, 표 문항에서 가장 크게 올랐습니다(68% → 80%). 대신 3090에서 문항당 시간이 4.1초에서 9.7초로 늘었습니다.
3. 틀린 답은 어디서 나왔나
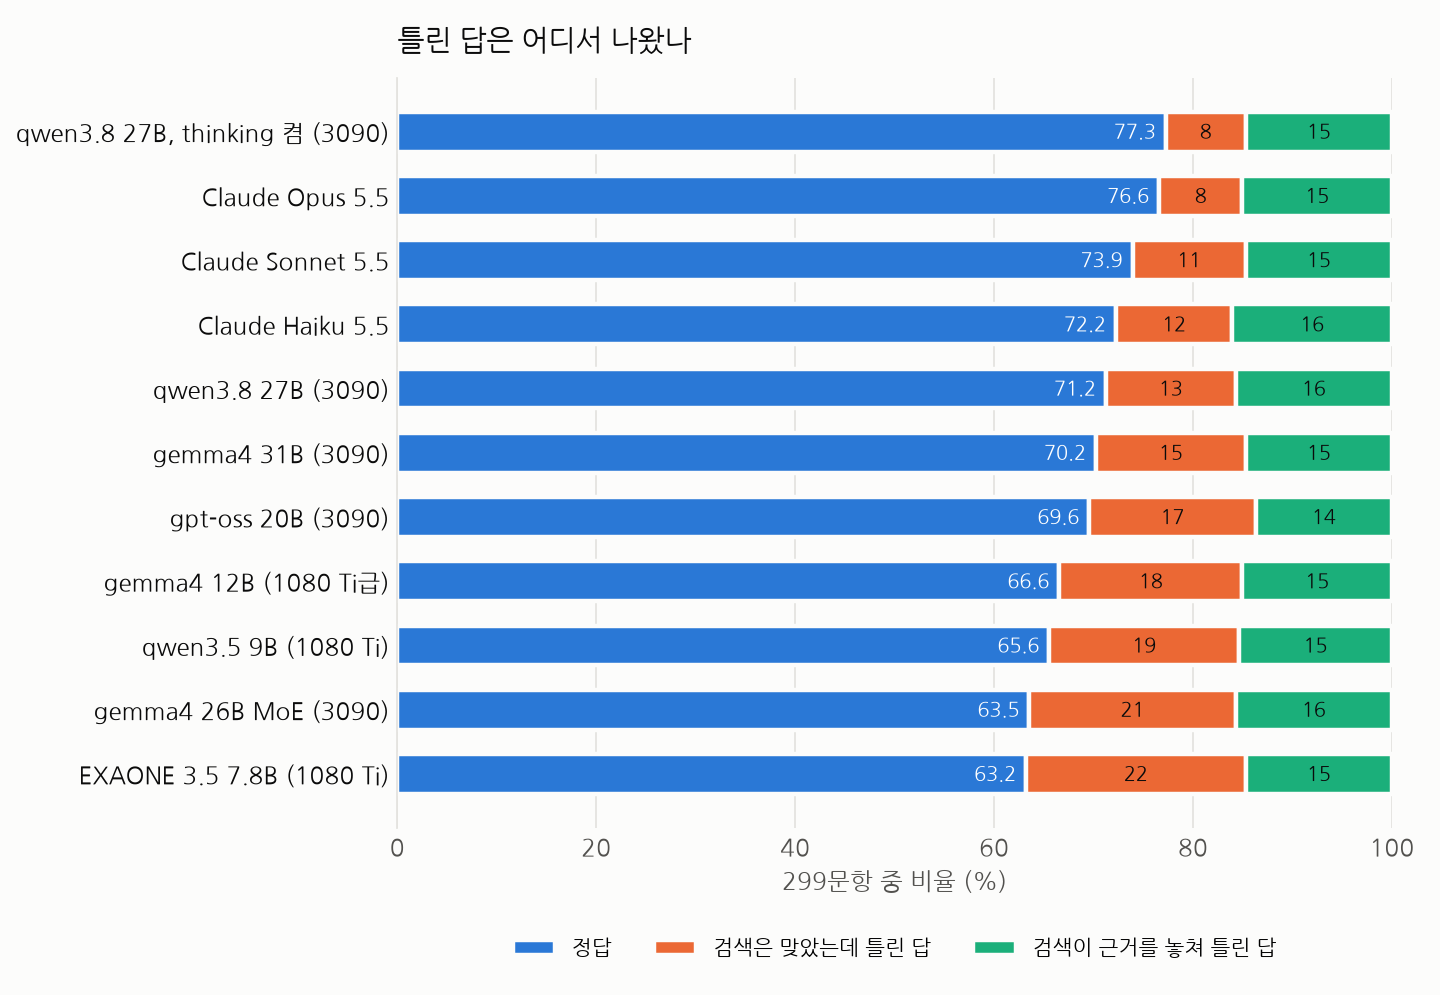
초록 막대는 근거 페이지가 상위 5쪽에 들어오지 못해 틀린 몫이고, 모든 모델에서 1416%로 거의 같습니다. 모델을 Opus로 바꿔도 이 부분은 줄지 않습니다. 근거를 못 받으면 대부분 못 맞힙니다(검색이 놓친 56문항의 정답률은 모델과 상관없이 1427%. 맞힌 경우는 다른 페이지에 비슷한 정보가 있었거나 모델이 원래 알던 내용으로 보이지만, 따로 확인하지는 않았습니다). 반면 주황 막대(근거를 받고도 틀린 답)는 모델이 좋아질수록 22%에서 8%까지 줄어듭니다.
초록 막대 안에는 성격이 다른 두 가지가 섞여 있습니다. 상위 두 모델이 틀린 문항을 나누면 이렇습니다.
| 틀린 이유 | Opus 5.5 (70문항) | qwen3.8 thinking 켬 (68문항) |
|---|---|---|
| 근거 페이지에 텍스트 층이 없음 (파싱) | 22 | 22 |
| 텍스트는 있는데 검색 순위에서 놓침 (검색) | 23 | 22 |
| 근거를 받고도 틀림 (생성) | 25 | 24 |
즉 상위 모델에서는 파싱과 검색이 틀린 문항의 3분의 2를 차지하고, 둘 다 생성 못지않게 큽니다. 생성 모델을 더 키우는 것보다 OCR을 붙이고 검색을 손보는 쪽에 남은 개선 여지가 더 많습니다.
4. 2024년 클라우드 RAG와 비교: 차이는 OCR에서 났다
| 2024 시스템 (공개 답변을 제 채점기로 재채점) | 전체 | 문단 | 표 | 이미지 |
|---|---|---|---|---|
| Allganize Alli + Claude 3.5 Sonnet | 80.6% | 90% | 64% | 67% |
| Allganize Alli + GPT-4o | 75.3% | 88% | 52% | 61% |
| OpenAI Assistant + GPT-4-turbo | 67.6% | 82% | 56% | 39% |
| LangChain 튜토리얼(pypdf, 1,000자 청크, OpenAI 임베딩) + GPT-4-turbo | 56.2% | 63% | 54% | 35% |
| Upstage + Solar | 56.2% | 67% | 44% | 28% |
| AnythingLLM + GPT-4-turbo | 20.1% | 16% | 8% | 23% |
위 표의 출처는 시험지에 함께 공개된 각 제품의 답변 원문이고, 채점만 제 채점기로 다시 했습니다.
2024년 Alli + Claude 3.5 Sonnet(80.6%)은 이번 제 파이프라인 + Opus 5.5(76.6%)보다 4%p 높았지만, 짝지어 보면 통계적으로 구분되지 않습니다(Alli만 맞힌 43 대 Opus만 맞힌 31, p=0.20). 어디서 갈렸는지 나눠 보면 이야기가 분명해집니다.
| 문항 묶음 | Alli + Claude 3.5 Sonnet | 제 파이프라인 + Opus 5.5 |
|---|---|---|
| 근거 페이지에 텍스트 층이 없는 23문항 | 19개 정답 | 1개 정답 |
| 그 밖의 276문항 (짝지어 한쪽만 맞힌 수) | 25 | 31 (p=0.50) |
| 이미지가 아닌 242문항 정답률 | 83.9% | 83.9% |
차이는 전부 텍스트 층이 없는 페이지에서 나왔습니다. 저는 OCR을 하지 않았으니 그런 페이지는 빈 페이지로 들어갑니다. Allganize는 페이지 단위 자체 파서(Allganize Parser)와 하이브리드 검색을 쓴다고 밝혔는데, 이 결과로 보면 그 파서가 스캔·그림 페이지의 글자를 읽어 내는 것으로 보입니다. 글자가 있는 페이지만 놓고 보면 2026년 Opus 쪽이 조금 더 맞혔습니다. 모델이 2년 새 한 세대 바뀌어도, OCR이 없는 파이프라인은 그 23문항을 메우지 못했습니다.
표 문항은 반대로 제 쪽이 높습니다(Opus 80% 대 64%, 짝지어 11 대 3, p=0.057). pymupdf4llm이 표를 마크다운으로 살려 준 덕분일 가능성이 있지만, 모델도 다르니 따로 확인하지는 못했습니다.
LangChain 기본 튜토리얼 + GPT-4-turbo(56.2%)는 1080 Ti 한 장의 qwen3.5 9B + 제 파이프라인(65.6%)보다 확실히 낮습니다(짝지어 28 대 56, p=0.003). 파싱·청크·검색 중 무엇이 얼마나 기여했는지는 나누지 못했습니다. 다만 2024년 상용 모델을 쓴 기본 파이프라인을, 2026년 9B 로컬 모델과 손본 파이프라인이 넘었다는 것은 분명합니다.
이 비교는 「모델 비교」가 아니라 조건이 다른 파이프라인 비교입니다. 2024 시스템의 검색 범위(문서 하나 안인지, 전체인지)도 공개되지 않았습니다.
5. 텍스트 층이 없는 페이지
생성에 쓴 pymupdf4llm 기준으로 1,450쪽 가운데 178쪽(약 12%)은 글자가 50자도 안 나오는 페이지였습니다(스캔본이나 통째로 그림인 페이지). 문서 4개는 아예 통째로 글자가 없었습니다.
| 문서 | 쪽수 | 추출된 글자 |
|---|---|---|
| KPMG 신명품 비즈니스 트렌드 보고서 | 32 | 0 |
| 서울아산병원 암 정보 | 11 | 0 |
| 공무원 재해보상 판례 | 9 | 0 |
| 가정의학 논문 1편 | 6 | 0 |
근거 페이지가 이런 페이지인 문항은 299개 중 23개(이미지 11, 문단 9, 텍스트 2, 표 1)입니다. 「문단」으로 분류된 문항도 9개나 됩니다. 사람 눈에는 글자가 보이는 페이지인데 PDF 안에는 그림으로만 들어 있는 경우입니다. 텍스트 추출만 쓰는 RAG는 이 문항들을 원천적으로 못 맞힙니다.
이미지 근거 57문항 중 나머지 46개는 근거 페이지에 글자가 있습니다. 답이 그 페이지의 그래프·도표 안에 있어서 텍스트 층에는 없거나 일부만 있습니다. 이 46문항에서는 Alli(30개)와 Opus(25개)의 차이가 작았습니다. 다음 단계는 비전 모델로 이런 페이지를 읽혀(OCR) 넣었을 때 23문항이 얼마나 회복되는지 재는 것입니다.
6. 문서에 답이 없는 질문 20개
시험지에는 없는 항목이라 제가 직접 만들었습니다. 도메인마다 3~5개씩, 그럴듯하지만 문서에 없는 내용을 물었습니다(예: 「2024 달라지는 세금제도에서 해외 거주 유튜버의 국내 광고수익에 적용되는 원천징수 세율은?」). 질문의 핵심 단어가 해당 도메인 문서 전체의 추출 텍스트에 한 번도 나오지 않는 것만 남겼습니다.
결과: 로컬 모델 전부(EXAONE 7.8B, qwen3.5 9B, gemma4 12B·26B·31B, gpt-oss 20B, qwen3.8 27B)와 Claude 세 모델 모두 20개 전부 「찾을 수 없다」고 답했습니다.
이 결과는 「모두 신중하다」보다 **「이 20문항이 너무 쉬웠다」**로 읽는 게 맞습니다. 질문이 묻는 정보가 문서에 아예 없었고, 지시문이 「없으면 찾을 수 없다고 하라」를 직접 말해 줬습니다. 정말 어려운 경우는 문서에 비슷한 숫자가 있는데 질문과 조건이 다를 때입니다. 이전 글 RAG 검증 단계에서도 진짜 숫자를 엉뚱한 질문에 붙이는 실수가 가장 잡기 어려웠습니다. 다음 실험은 그쪽으로 문항을 만들겠습니다.
제가 처음에 틀렸던 것: 첫 집계에서는 EXAONE이 8개를 지어냈다고 나왔습니다. 답을 직접 읽어 보니 8개 모두 「문서에 명시되어 있지 않습니다」라는 거절이었고, 제 거절 판정 정규식이 「명시되어 있지 않」 같은 표현을 놓친 것이었습니다. 규칙 기반 판정도 결과를 눈으로 확인해야 합니다.
한계도 있습니다. 질문의 핵심 단어가 텍스트 층이 없는 페이지 속에 있었을 가능성은 확인할 수 없습니다.
7. 속도: 1080 Ti와 3090
같은 30문항(5쪽 문맥, 프롬프트 길이 중앙값 약 3,200~3,600토큰)을, 모델이 GPU에 다 올라간 상태에서 잰 값입니다. 문항당 시간은 프롬프트 처리부터 답변 끝까지 걸린 시간의 중앙값입니다.
| 모델 | GTX 1080 Ti (Ollama 0.40.5) | RTX 3090 (Ollama 0.40.2) |
|---|---|---|
| EXAONE 3.5 7.8B | 9.1초 (한 장) | — |
| qwen3.5 9B | 8.4초 (한 장) | — |
| gemma4 12B | 10.0초 (한 장) | 2.0초 |
| qwen3.8 27B | 30.9초 (두 장)* | 4.0초 |
| qwen3.8 27B, thinking 켬 | — | 9.7초* |
| gemma4 26B MoE | — | 1.6초* |
| gpt-oss 20B | — | 4.4초* |
| gemma4 31B | — | 63초* |
*표시는 30문항 측정이 아니라 320문항 본 실행의 중앙값입니다(num_ctx 16384).
- 같은 3090에서 gemma4 31B는 qwen3.8 27B보다 약 15배 느렸습니다. Ollama 표시로는 전부 GPU에 올라갔는데(19.3GB) 프롬프트 처리가 초당 75토큰에 그쳤습니다(qwen3.8은 약 1,270토큰). 31B를 쓰려면 이 문제부터 확인해야 합니다.
- 1080 Ti 두 장으로도 qwen3.8 27B는 돌아갑니다. 다만 3090보다 7~8배 느립니다(320문항 본 실행 기준 프롬프트 초당 173토큰, 생성 초당 12.7토큰).
- 같은 qwen3.8 27B, 같은 설정(temperature 0)인데 **1080 Ti 두 장(Ollama 0.40.5)에서는 72.2%, 3090(0.40.2)에서는 71.2%**가 나왔습니다. 11문항의 판정이 엇갈려(1080 Ti 쪽만 맞힘 7, 3090 쪽만 맞힘 4) 순 3문항 차이입니다. 장비·버전만 바뀌어도 이만큼 흔들리니, 모델 사이 1~2%p 차이를 순위로 읽으면 안 됩니다.
- qwen3.5 9B는 Ollama 버전에 따라 3배 차이가 났습니다. 0.30.2는 이 모델을 1080 Ti 한 장에 다 올리지 못하고 일부를 CPU로 돌려(11.4GB로 잡고 그중 3.3GB만 GPU) 문항당 23초가 걸렸습니다. 0.40.5는 약 5.5GB로 전부 GPU에 올려 8.4초였습니다.
8. 돌리다 걸린 함정
- Ollama 0.30.2는 gemma4 12B를 아예 못 올립니다.
unknown model architecture: 'gemma4-assistant'오류로 320문항이 전부 실패했고, 답변은 3090(0.40.2)에서 다시 만들었습니다. 오류가 답변 칸에 조용히 쌓이니, 끝나고 빈 답 개수를 꼭 세 보세요. - gpt-oss 20B는 생각(reasoning)을 끌 수 없습니다. 처음에 출력 한도를 1,024토큰으로 두었더니 48개는 생각하다 한도에 걸려 빈 답이 됐고, 28개는 답이 문장 중간에서 잘렸습니다. 결국 320문항 전체를 8,192토큰 한도로 다시 돌렸습니다. 그래도 2문항(q_78, q_212)은 8,192토큰을 다 쓰도록 생각만 하다 빈 답이 됐고, 오답으로 셌습니다. 정답률은 처음 57.5%(빈 답 48개 포함)에서 69.6%로 올랐습니다. 처음 숫자로 순위를 냈다면 설정 실수를 모델 탓으로 돌린 셈입니다.
- bge-m3 임베딩을 16개씩 묶어 보내면 Ollama 러너가 죽었습니다(
connection refused). 한 개씩 보내고 재시도를 넣으니 해결됐습니다. - Claude Batch API는 반값이지만 언제 끝날지 모릅니다. Sonnet·Haiku는 1시간 안에 끝났는데, Opus는 2시간 넘게 처리 0건으로 보였습니다. 취소를 눌러 보니 사실은 이미 거의 다 처리된 상태였습니다. 상태 표시가 늦게 바뀝니다.
- 원문 PDF는 상당수가 직접 받아지지 않습니다. 데이터셋의 링크 상당수가 PDF가 아니라 정부·법원 게시판 페이지라서 64개 중 43개가 실패했습니다.
비용
Claude 세 모델의 답변 320문항(입력 약 185만 토큰/모델)은 Batch API로 Opus 5.5 약 $5.7, Sonnet 5.5 약 $2.4, Haiku 5.5 약 $0.15였습니다. 두 번째 채점기(Opus 5.5 일반 호출)는 입력 약 257만, 출력 약 9만 토큰으로 약 $12.2였습니다(Claude 사용액 합계 약 $20)입니다. 로컬은 전기료뿐입니다.
한계
- 채점은 LLM이 했습니다. 주 채점기는 Allganize 판정과 88.5% 일치하도록 검증했고, 다른 계열의 두 번째 채점기로도 결론이 같았습니다. 그래도 개별 문항 판정에는 오차가 있습니다. 두 번째 채점기(Opus)는 Claude 답변에 더 후했으니, Claude와 로컬의 비교는 주 채점기 기준을 함께 보세요.
- 로컬 모델은 한 번씩만 돌렸습니다(temperature 0). 같은 모델도 장비·Ollama 버전이 바뀌면 11문항이 엇갈렸습니다(7번). 모델 간 2~3%p 차이는 위 검정처럼 우연 범위일 수 있습니다.
- 2024 클라우드 시스템은 각자 다른 파서·검색을 썼고, 검색 범위도 공개되지 않았습니다. 그 비교는 조건이 완전히 같지 않은 파이프라인 비교입니다.
- 시험지 문서는 2008~2024년 공개 문서이고, 사내 문서와는 성격이 다를 수 있습니다.
재현
ko-rag-eval.zip에 이 글의 모든 단계 스크립트, 실행 전에 적은 예측(PREDICTIONS.md), 직접 만든 답 없는 질문 20개, 시스템별·문항별 O/X 판정(verdicts.csv, 두 채점기 모두)을 넣었습니다. 시험지와 PDF는 재배포하지 않았으니 위 Hugging Face 두 곳에서 받으세요.
순서는 parse.py → retrieve.py → gen.py(로컬) 또는 claude_gen.py(Claude) → score.py(주 채점기) / judge2.py(두 번째 채점기)입니다. 2024 시스템 재채점은 rescore_cloud.py, 채점기 검증은 validate_judge.py, 속도 측정은 timing.py, 그림은 figs.py입니다. 파이썬 패키지는 pymupdf pymupdf4llm pypdf rank_bm25 kiwipiepy numpy requests pyarrow pandas statsmodels matplotlib, Claude를 돌리려면 anthropic이 필요합니다.
다음에 읽을 글
- 로컬 LLM 설치 가이드 2026 (1080 Ti 실측): 이 글에 나온 모델들을 처음 설치하는 법
- Ollama num_ctx 함정: 컨텍스트를 늘리면 속도가 얼마나 떨어지나
- RAG에 검증 단계를 붙여 본 기록 (영문): 답의 근거를 문장 단위로 확인하는 방법
관련 글
로컬 LLM 설치 가이드 2026 — Ollama 설치부터 모델 고르기까지 (GTX 1080 Ti 실측)
10월 17일 · 17 min read
Local LLMLocal RAG Scored on 300 Questions: a 27B on One RTX 3090 Tied Claude Opus 5.5, and Most Misses Happened Before the Model
10월 21일 · 17 min read
Local LLMBuilding a Fully-Local Research RAG on 2× GTX 1080 Ti + an RTX 3090: 3 Gotchas (CPU Embeddings, the Context Trap, and Not Merging GPUs)
6월 6일 · 6 min read
Local LLMRunning Brand-New Gemma 4 12B on an 8-Year-Old GTX 1080 Ti: Speed, 3 Gotchas, and Why Q8 Beat Q4 on My Own Field
6월 5일 · 6 min read