엔비디아 Nemotron 3.5 Bolt E4B, 한국어 문서 RAG 300문항으로 채점해 보니: 바탕 모델 gemma4 E4B와 같은 조건 비교
엔비디아가 10월 23일 공개한 4B급 로컬 모델 Nemotron 3.5 Bolt E4B를 정답이 있는 한국어 문서 RAG 시험지로 채점했습니다. 바탕 모델인 gemma4 E4B와 같은 검색 결과·같은 지시문·같은 채점기로 생각 모드를 끄고 켜서 비교했고, GTX 1080 Ti와 RTX 3090 속도, Ollama에서 생각 모드를 켜는 방법도 정리했습니다.
이 글의 숫자는 모두 제 서버에서 직접 돌려 채점한 값입니다. 시험지와 다른 모델 결과는 「로컬 RAG, 한국어 문서에 정말 맞게 답할까」와 같습니다. (English version: Nemotron 3.5 Bolt E4B on a Korean document-QA benchmark)
요약
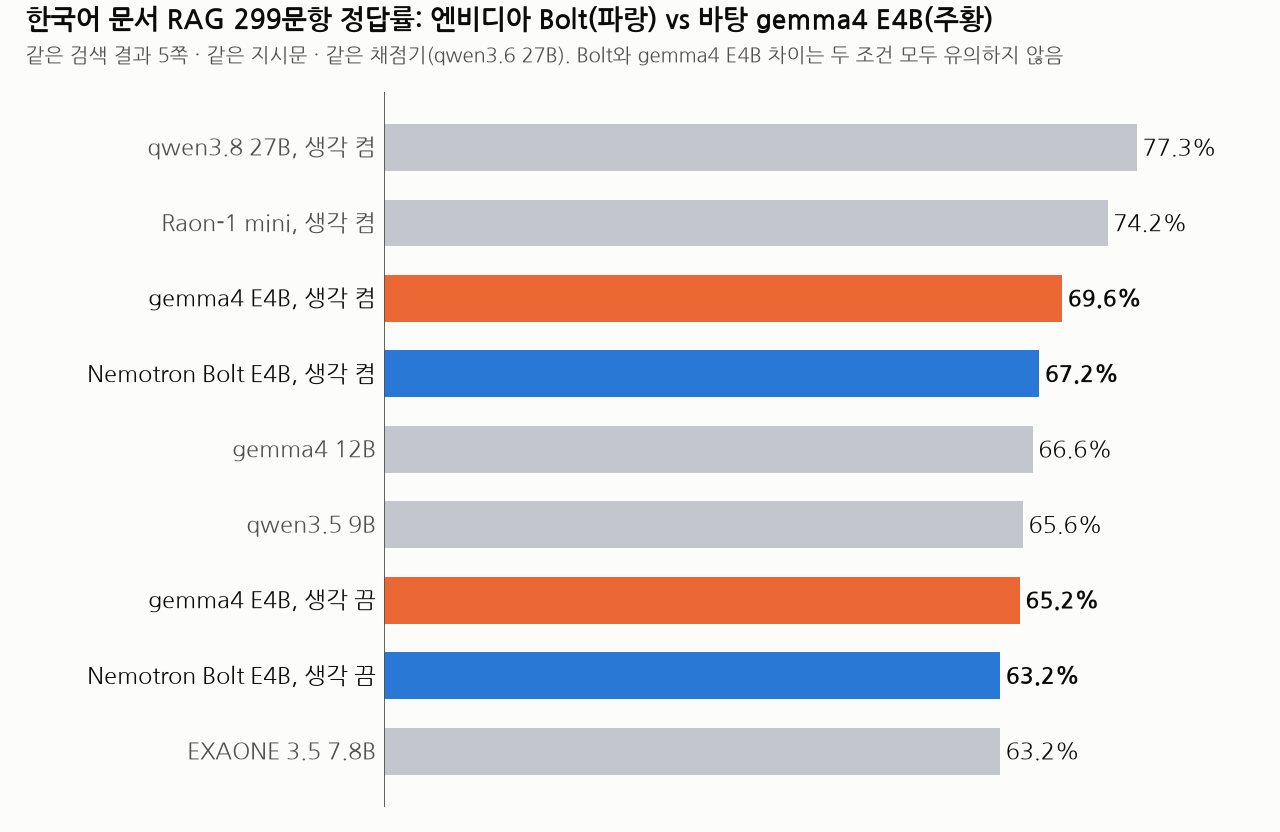
- 정답률(299문항): 생각 모드를 켜면 Bolt 67.2% vs 바탕 모델 gemma4 E4B 69.6%, 끄면 63.2% vs 65.2%.
- 두 조건 모두 Bolt와 바탕 모델 사이에 차이가 검출되지 않았습니다(같은 문항 짝비교 p=0.27, 0.31). 엔비디아의 추가 학습으로 한국어 문서 질의응답에서 측정할 만한 향상은 없었습니다(두 조건 모두 바탕 모델이 2%p 높았지만 우연 범위).
- 엔비디아는 RAG 근거 벤치마크 GaRAGe에서 Bolt가 바탕 모델보다 약 10점(Q4_K_M 기준 40.7 대 30.9) 높다고 발표했지만, 이 한국어 시험지에서는 그런 차이가 보이지 않았습니다. GaRAGe는 영어 중심이고 채점 방식도 달라서, 엔비디아 숫자가 틀렸다는 뜻은 아닙니다. 「그 향상이 한국어 문서 질의응답까지 이어지지는 않았다」는 뜻입니다.
- 생각을 켜면 두 모델 모두 약 4%p 오르고, 문항당 시간은 3~4배가 됩니다. 생각을 켠 Bolt(67.2%)는 gemma4 12B(66.6%)·qwen3.5 9B(65.6%)와 같은 수준입니다.
- 파일이 6.2GB라 크기로는 GTX 1080 Ti(11GB) 한 장에 들어갑니다(이번 측정은 1080 Ti 두 장짜리 서버). RTX 3090에서는 초당 약 135토큰을 씁니다.
- Ollama로 받으면 생각 모드가 꺼진 채로만 돕니다. 아래에 켜는 방법을 적었습니다.
Nemotron 3.5 Bolt E4B가 뭔가
엔비디아가 2026년 10월 23일 Hugging Face에 공개한 소형 모델입니다(모델 카드).
- 구글 Gemma 4 E4B(지시형)를 바탕으로 엔비디아가 추가 학습한 모델입니다. 전체 8B, 실제로 쓰는 파라미터는 약 4B입니다.
- 추가 학습은 지시 따르기, 여러 단계 도구 호출, 여러 턴 대화, 구조화된 출력을 겨냥한 강화학습(GRPO)입니다. 음성 비서·기기 안 비서처럼 빠르고 메모리를 적게 쓰는 용도를 내세웁니다.
- 공개 파일은 Q4_K_M GGUF 하나(6.18GB)입니다. 이름에 「4GB」가 붙어 있지만 파일은 6GB가 넘습니다.
- 라이선스는 OpenMDW-1.1이고 상업적으로 쓸 수 있습니다(바탕 Gemma 4는 Apache 2.0).
한국어 지원은 애매합니다. 카드 본문은 지원 언어로 영어·스페인어·프랑스어·독일어·이탈리아어·일본어를 들고 「등」이라고 적었습니다. 반면 카드 맨 위 메타데이터의 언어 목록 34개에는 한국어(ko)가 들어 있습니다. 그래서 「한국어 문서를 주면 제대로 답하나」를 직접 쟀습니다.
엔비디아가 발표한 숫자는 모두 **생각 모드(reasoning)**에서 잰 것입니다(RoleBench 등 일부 제외). 그래서 이 글도 생각 모드를 끈 것과 켠 것을 둘 다 쟀습니다.
측정 조건
| 항목 | 내용 |
|---|---|
| 시험지 | Allganize 한국어 RAG 평가 데이터 300문항(금융·공공·의료·법률·커머스), 근거 페이지 번호가 빈 1문항을 뺀 299문항 + 제가 만든 「문서에 답 없는 질문」 20개 |
| 검색 | 도메인 문서 전체에서 하이브리드(kiwi 형태소 BM25 + bge-m3) 상위 5쪽. 모든 모델이 같은 5쪽을 받음 |
| 지시문 | 「발췌만 근거로 답하고, 없으면 찾을 수 없다고 하라」 |
| 모델 | Bolt: 엔비디아 Q4_K_M GGUF(6.18GB) / 바탕 모델: Ollama 공식 gemma4:e4b(Q4_K_M) |
| 실행 | Ollama 0.40.5, GTX 1080 Ti 두 장(PD 서버), temperature 0, 문맥 16,384 |
| 출력 한도 | 생각 끔 1,024토큰, 켬 8,192토큰 |
| 채점 | qwen3.6 27B(지난 글에서 Allganize 판정과 88.5% 일치 검증) |
이번에는 두 번째 채점기(Claude Opus 5.5)를 쓰지 않았습니다. 대신 두 모델의 판정이 엇갈린 문항을 AI 검토자(Claude)에게 한 번 더 읽혔습니다(아래).
결과
| 모델 | 정답률 | 검색이 맞았을 때 | 문단 | 텍스트 | 표 | 이미지 |
|---|---|---|---|---|---|---|
| gemma4 E4B, 생각 켬 | 69.6% | 81.1% | 86% | 69% | 66% | 32% |
| Bolt E4B, 생각 켬 | 67.2% | 78.6% | 83% | 64% | 62% | 33% |
| gemma4 E4B, 생각 끔 | 65.2% | 75.7% | 82% | 62% | 52% | 35% |
| Bolt E4B, 생각 끔 | 63.2% | 74.5% | 83% | 58% | 52% | 26% |
문항 수는 문단 147, 텍스트 45, 표 50, 이미지 57이고, 「검색이 맞았을 때」는 근거 페이지가 상위 5쪽에 들어온 243문항입니다. 문서에 답이 없는 20문항은 네 조건 모두 20개를 다 「찾을 수 없다」고 답했습니다. 비교한 다른 모델도 모두 20개를 거절했기 때문에, 이 20문항으로는 모델을 가를 수 없습니다.
같은 문항으로 짝지어 비교(McNemar 정확 검정, 299문항. 「A만」은 A만 맞히고 B는 틀린 문항 수)
| 비교 | A만 / B만 (p) |
|---|---|
| Bolt 생각 켬 vs gemma4 E4B 생각 켬 | 11 / 18 (0.27) |
| Bolt 생각 끔 vs gemma4 E4B 생각 끔 | 9 / 15 (0.31) |
| Bolt 생각 켬 vs 끔 | 23 / 11 (0.06) |
| gemma4 E4B 생각 켬 vs 끔 | 22 / 9 (0.03) |
| Bolt 생각 켬 vs gemma4 12B | 17 / 15 (0.86) |
| Bolt 생각 켬 vs qwen3.5 9B | 23 / 18 (0.53) |
읽는 법:
- Bolt와 바탕 모델은 같은 수준입니다. 두 조건 모두 바탕 모델이 2%p 높게 나왔지만 우연 범위입니다. 「같다는 증명」은 아니고, 이 시험지 크기로는 차이가 검출되지 않았다는 뜻입니다.
- 생각 모드는 둘 다 도움이 됐습니다. 4%p 안팎이고, gemma4 E4B는 유의(p=0.03), Bolt는 경계(p=0.06)입니다. 생각을 포함한 생성 토큰은 중앙값으로 Bolt 약 650, gemma4 약 780토큰이었고, 생각만 하다 출력 한도에 걸린 문항은 둘 다 0개였습니다.
- 생각을 켠 4B급 두 모델은 지난 글의 gemma4 12B·qwen3.5 9B와 같은 수준입니다.
채점기를 얼마나 믿을 수 있나
생각 끔 조건에서 두 모델의 판정이 엇갈린 24문항을 AI 검토자(Claude)에게 다시 읽혔습니다(사람이 전부 읽은 것은 아닙니다). 채점기 판정 48개 중 9개가 틀렸다는 판단이 나왔습니다. 내용이 같은 답이 줄바꿈·글머리표 형식만 달라 다르게 채점된 경우도 있었습니다. 이 9개를 고쳐 다시 세면 Bolt 193, gemma4 E4B 198(p=0.30)로, 결론은 같습니다. 판정이 엇갈린 문항은 원래 채점 오류가 몰리는 곳이라 전체 오류율은 이보다 낮지만, 2%p 차이는 채점기 오차 안에 있다고 보는 게 맞습니다.
눈에 띈 차이
- Bolt가 답이 짧습니다. 답 가능한 299문항에서 글자 수 중앙값이 Bolt 99자, gemma4 E4B 126자였습니다. 엔비디아 카드가 「간결함(Brevity)」 점수를 내세운 것과 맞습니다.
- Bolt가 조금 더 자주 「찾을 수 없다」고 합니다. 근거 페이지가 검색됐는데도 「찾을 수 없다」는 표현이 들어간 답이 Bolt 16번, gemma4 E4B 11번이었습니다(생각 끔, 일부를 답한 뒤 덧붙인 경우 포함). 다만 유의한 차이가 아니고, 점수로는 1문항 차이였습니다.
- 생각 끔 조건의 이미지 문항(텍스트가 그림 속에만 있는 문항)은 Bolt 26%, gemma4 35%였지만 57문항뿐이라 참고만 하세요.
Ollama에서 돌리기, 그리고 생각 모드 켜기
모델 카드의 명령 그대로 받으면 됩니다.
ollama run hf.co/nvidia/NVIDIA-Nemotron-3.5-Bolt-E4B-4GB:Q4_K_M
다만 이렇게 받으면 생각 모드를 쓸 수 없습니다. API에 "think": true를 넣으면 does not support thinking 오류가 납니다(Ollama 0.40.5). GGUF에 들어 있는 대화 템플릿을 Ollama가 생각 기능으로 알아보지 못해서입니다.
Bolt의 템플릿은 Gemma 4와 같은 생각 토큰(<|think|>, <|channel>)을 씁니다. 그래서 같은 파일을 Ollama의 gemma4 형식으로 다시 등록하면 생각 모드가 켜집니다.
# Modelfile
FROM hf.co/nvidia/NVIDIA-Nemotron-3.5-Bolt-E4B-4GB:Q4_K_M
TEMPLATE {{ .Prompt }}
RENDERER gemma4
PARSER gemma4
ollama create bolt-e4b-think -f Modelfile
이 방식이 원래 템플릿과 같은 답을 내는지 30문항으로 확인했습니다(생각 끔, temperature 0). 23문항은 글자까지 같았고, 나머지 7문항은 띄어쓰기나 표현만 달랐습니다(내용은 같음). 이 글의 생각 끔 결과는 원래 템플릿, 생각 켬 결과는 이 방식으로 돌린 것입니다.
llama.cpp 서버(--jinja, chat_template_kwargs.enable_thinking)로도 생각 모드는 켜지지만, 제 GTX 1080 Ti에서는 생성이 초당 13~15토큰으로 Ollama보다 3배 느려서 이번 측정에는 쓰지 않았습니다.
속도: GTX 1080 Ti vs RTX 3090
같은 30문항, 생각 끔, 모델 전체가 GPU에 올라간 것을 확인하고 잰 중앙값입니다(프롬프트는 문항당 약 3,500토큰).
| GTX 1080 Ti (Ollama 0.40.5) | RTX 3090 (Ollama 0.40.2, Windows) | |
|---|---|---|
| Bolt 생성 | 초당 45토큰 | 초당 135토큰 |
| gemma4 E4B 생성 | 초당 94토큰 | 초당 138토큰 |
| 프롬프트 처리 | 초당 약 1,130~1,190토큰 | 초당 약 7,000토큰 |
| 문항당 | 4.5~4.7초 | Bolt 1.1초 / gemma4 1.4초 |
- 1080 Ti에서 Bolt가 절반 속도로 나온 건 모델 자체보다 포장 차이일 가능성이 큽니다. Ollama 공식
gemma4:e4b에는 작은 보조 모델(약 7,800만 개 파라미터)이 함께 들어 있어서, 다음 단어를 미리 추측하는 방식(speculative decoding)으로 생성을 빠르게 합니다. 엔비디아가 올린 Bolt GGUF에는 이 보조 모델이 없습니다. 둘의 본체 구조는 같습니다(gemma4, 42층). 다만 같은 「Q4_K_M」이라도 텐서 구성은 다릅니다(Bolt 6.18GB는 임베딩을 Q8_0으로, gemma4:e4b 본체 5.49GB는 주로 Q6_K로 저장). 보조 모델을 끄고 비교하는 실험은 하지 않았습니다. 엔비디아는 Bolt용 보조 모델(DFlash)을 따로 공개했는데, 모델 카드에 llama.cpp 설정만 나와 있어 이번엔 쓰지 않았습니다. - 3090에서는 둘 다 초당 135토큰 안팎으로 비슷했습니다. 문항당 시간 차이는 Bolt의 답이 짧아서입니다.
- 1080 Ti에서는 문항당 시간이 거의 같습니다. 3,500토큰짜리 프롬프트를 읽는 시간이 대부분이기 때문입니다.
- 생각을 켜면 1080 Ti에서 문항당 중앙값이 Bolt 17.6초, gemma4 E4B 12.9초였습니다(gemma4는 보조 모델 덕분에 빠름).
한계
- 한 번씩만 돌렸습니다. 같은 모델도 장비·버전이 바뀌면 판정이 10문항쯤 엇갈린 적이 있으니, 2%p 차이를 순위로 읽지 마세요.
- Q4_K_M 하나만 썼습니다. 엔비디아가 낸 숫자에도 원본(BF16)과 Q4_K_M 사이에 차이가 있습니다.
- 생각 끔과 켬의 템플릿 경로가 다릅니다(위 「Ollama에서 돌리기」 참고). 30문항 확인에서 내용 차이는 없었습니다.
- 채점은 LLM 하나가 했고, 엇갈린 문항만 다른 AI 검토자로 다시 봤습니다(사람이 전부 확인한 것은 아닙니다).
- temperature 0으로 돌렸습니다. 모델 카드는 temperature 1.0, top_p 0.95를 권장합니다.
- 두 파일 모두 「Q4_K_M」이지만 텐서 구성이 조금 다릅니다(위 속도 절 참고).
- 한국어 공공 문서 시험지 하나의 결과입니다. 엔비디아가 강조한 도구 호출·여러 턴 대화·역할극은 재지 않았습니다. 「한국어 문서에서 근거로 답하기」에 한정한 결론입니다.
재현
생성·채점 스크립트와 문항별 판정은 지난 글의 재현 파일에 추가했습니다. 그림은 figs_bolt.py, 생각 모드 실행은 chain_bolt_think.sh입니다.
다음에 읽을 글
- 로컬 RAG, 한국어 문서에 정말 맞게 답할까 (300문항 채점): 이 글의 시험지와 다른 모델들 결과
- 크래프톤 Raon-1 mini, 한국어 문서 RAG 300문항으로 채점해 보니: 같은 시험지로 잰 국산 MoE
- 로컬 LLM 설치 가이드 2026 (1080 Ti 실측): Ollama로 돌릴 수 있는 모델들
관련 글
NVIDIA Nemotron 3.5 Bolt E4B on a Korean Document-QA Benchmark: Scored Against Its Base Model, gemma4 E4B
10월 26일 · 9 min read
AI/ML크래프톤 Raon-1 mini, 한국어 문서 RAG 300문항으로 채점해 보니: 3090 한 장·1080 Ti 두 장에서 돌린 결과
10월 22일 · 18 min read
AI/ML로컬 RAG, 한국어 문서에 정말 맞게 답할까 — 정답 있는 300문항으로 채점해 보니 로컬 27B가 Opus 5.5와 비겼고, 남은 점수는 파싱과 검색에서 샜다
10월 21일 · 33 min read
Local LLMKrafton's Raon-1 mini on a Korean Document-QA Benchmark: 300 Questions with Known Answers, Run on an RTX 3090 and Two GTX 1080 Tis
10월 22일 · 11 min read