Nanbeige4.3 33B, 한국어 문서 RAG 300문항으로 채점해 보니: 모델 카드에서 qwen3.8 27B를 앞선 모델, 같은 조건으로 비교
10월 24일 공개된 33B 오픈 모델 Nanbeige4.3을 정답이 있는 한국어 문서 RAG 시험지로 채점했습니다. 모델 카드가 비교한 qwen3.8 27B와 같은 검색 결과, 같은 지시문, 같은 채점기로 쟀고, 출력 한도에 걸려 답을 못 쓴 문항을 다시 돌린 과정과 RTX 3090 속도도 정리했습니다.
이 글의 숫자는 모두 제 서버에서 직접 돌려 채점한 값입니다. 시험지와 다른 모델 결과는 「로컬 RAG, 한국어 문서에 정말 맞게 답할까」와 같습니다. (English version: Nanbeige4.3 33B on a Korean document-QA benchmark)
요약
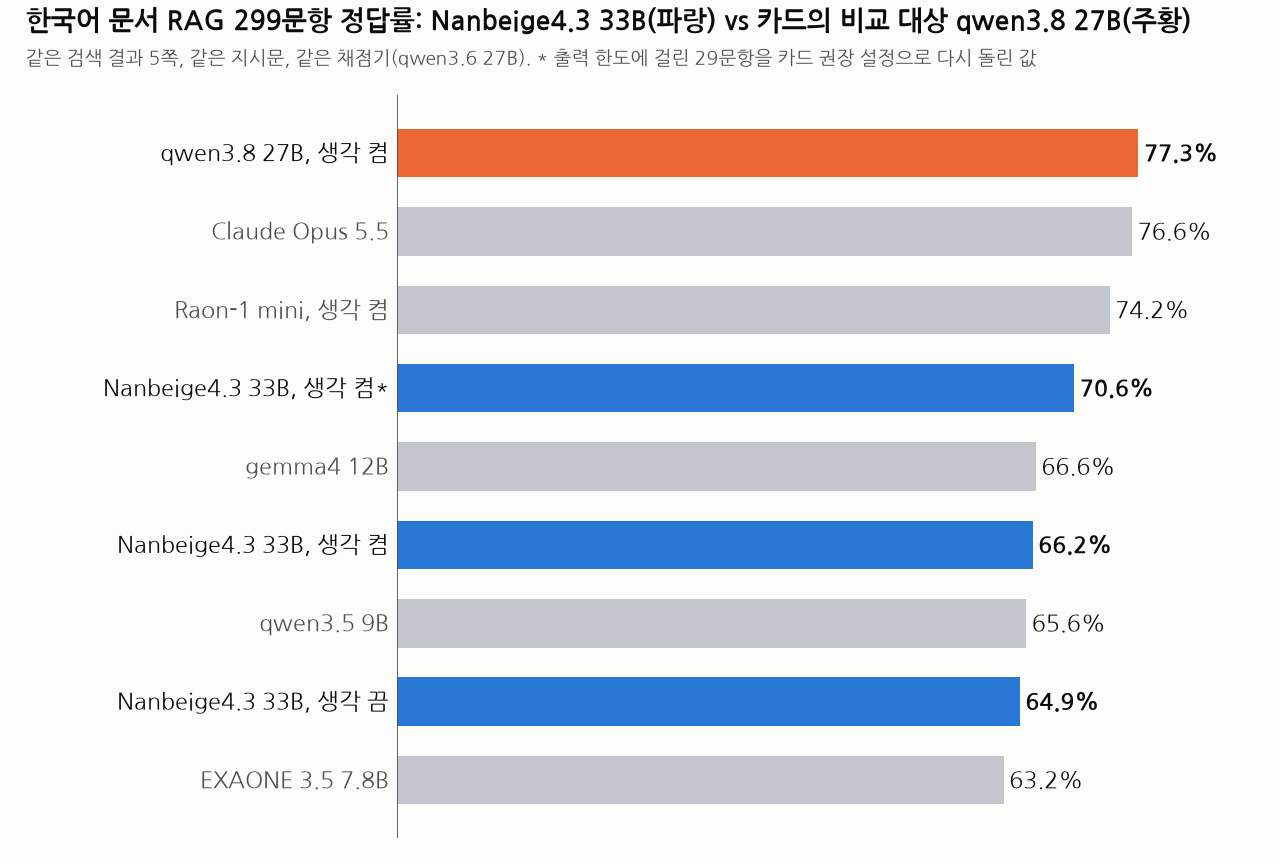
- 정답률(299문항): 생각 끔 64.9%, 생각 켬 66.2%. 출력 한도에 걸렸던 29문항을 카드 권장 설정으로 다시 돌리면 생각 켬 70.6%.
- 모델 카드가 비교한 qwen3.8 27B(생각 켬 77.3%)보다 낮습니다. 다시 돌린 70.6%로 비교해도 Nanbeige만 맞힌 문항 6개, qwen만 맞힌 문항 26개입니다(p 0.001 미만).
- 다른 모델과 같은 조건의 점수(66.2%, 64.9%)는 gemma4 12B(66.6%), qwen3.5 9B(65.6%)와 같은 자리입니다. 같은 조건에서는 33B 모델이 9~12B 모델과 비슷하게 나왔습니다.
- 두 번째 채점기(Claude Opus 5.5)로 다시 채점해도 결론이 같습니다. Opus 채점으로 Nanbeige(다시 돌림) 73.2%, qwen3.8 27B 80.6%이고, Nanbeige만 맞힌 문항 3개, qwen만 맞힌 문항 25개입니다(p 0.001 미만). qwen 계열 채점기가 qwen 편을 든 흔적은 없었습니다.
- 카드 표의 에이전트 코딩, 업무 자동화, 추론 벤치마크 20개 중 18개에서 Nanbeige가 qwen3.8 27B보다 높습니다(SWE-Bench Pro와 GDPval 두 개는 qwen이 높음). 한국어나 문서 질의응답 결과는 카드에 없고, 카드의 언어 표시는 영어와 중국어뿐입니다. 그래서 이 결과는 카드 숫자가 틀렸다는 뜻이 아니고, 그 우위가 한국어 문서 질의응답까지 이어지지 않았다는 뜻입니다.
- 처음 잰 생각 켬에서 29문항이 출력 한도 8,192토큰에 걸렸고, 그중 20문항은 생각하다 잘려서 답이 비어 있었습니다. 그 29문항을 다시 돌린 과정이 이 글의 절반입니다. 같은 실수를 막도록 측정 도구도 고쳤습니다.
- RTX 3090에서 초당 약 38토큰, 문항당 약 18초(생각 끔)입니다. 같은 3090에서 qwen3.8 27B는 초당 약 85토큰, 4초였습니다.
Nanbeige4.3 33B가 뭔가
2026년 10월 24일 Hugging Face에 올라온 330억 파라미터 모델입니다(모델 카드).
- 카드는 이 모델을 Nanbeige4.3 시리즈의 **「교사 모델」**로 소개합니다. 먼저 큰 에이전트 모델을 만들고, 그 능력을 작은 모델(예: Nanbeige4.3-3B)로 증류하겠다는 계획입니다.
- 내세우는 분야는 **에이전트 코딩과 업무 자동화(cowork)**입니다. Terminal-Bench, SWE-Bench Pro, Automation Bench 같은 벤치마크에서 qwen3.8 27B, Gemma4 31B 등과 비교했고, 모두 「가장 높은 생각 강도」로 쟀다고 적었습니다.
- 라이선스는 Apache 2.0입니다.
- 카드의 언어 표시는 영어(en)와 중국어(zh) 둘뿐입니다. 한국어는 적혀 있지 않습니다.
한국어를 내세운 모델이 아닌데 왜 쟀냐면, 카드가 qwen3.8 27B와 정면으로 비교했기 때문입니다. qwen3.8 27B는 이 시험지에서 로컬 모델 1위이고 Claude Opus 5.5와 같은 수준이었습니다. 「카드의 벤치마크에서 qwen3.8 27B를 앞선 모델이 한국어 문서에서는 어떤가」를 확인하고 싶었습니다.
측정 조건
| 항목 | 내용 |
|---|---|
| 시험지 | Allganize 한국어 RAG 평가 데이터 300문항(금융, 공공, 의료, 법률, 커머스). 근거 페이지 번호가 빈 1문항을 뺀 299문항과, 제가 만든 「문서에 답 없는 질문」 20개 |
| 검색 | 도메인 문서 전체에서 하이브리드(kiwi 형태소 BM25 + bge-m3) 상위 5쪽. 모든 모델이 같은 5쪽을 받음 |
| 지시문 | 「발췌만 근거로 답하고, 없으면 찾을 수 없다고 하라」 |
| 모델 | bartowski의 Q4_K_S GGUF(19.7GB). 비교한 qwen3.8 27B는 Ollama 공식 Q4_K_M |
| 실행 | Ollama 0.40.2, RTX 3090(24GB, 모델 전체가 GPU에 올라감), temperature 0, 문맥 16,384 |
| 출력 한도 | 생각 끔 1,024토큰, 켬 8,192토큰(다른 모델과 같음) |
| 채점 | 주 채점기 qwen3.6 27B(첫 글에서 Allganize 판정과 88.5% 일치 검증), 두 번째 채점기 Claude Opus 5.5(같은 채점 프롬프트) |
Q4_K_M(20.8GB)이 아니라 한 단계 작은 Q4_K_S(19.7GB)를 쓴 건 3090 한 장에 여유를 두고 다 올리려고서였습니다. Q4_K_S는 문맥 16,384에서 21.7GB를 썼고, Q4_K_M은 시도하지 않았습니다.
결과
| 조건 | 정답률 | 두 번째 채점기 | 검색이 맞았을 때 | 문단 | 텍스트 | 표 | 이미지 |
|---|---|---|---|---|---|---|---|
| qwen3.8 27B, 생각 켬 | 77.3% | 80.6% | 90.1% | 87% | 84% | 80% | 44% |
| Nanbeige 생각 켬, 29문항 다시 돌림 | 70.6% | 73.2% | 81.5% | 82% | 71% | 76% | 37% |
| Nanbeige 생각 켬 | 66.2% | 69.2% | 76.5% | 78% | 64% | 70% | 35% |
| Nanbeige 생각 끔 | 64.9% | 66.9% | 76.1% | 80% | 71% | 54% | 30% |
문항 수는 문단 147, 텍스트 45, 표 50, 이미지 57이고, 「검색이 맞았을 때」는 근거 페이지가 상위 5쪽에 들어온 243문항입니다. 문서에 답이 없는 20문항은 세 조건 모두 19개를 「찾을 수 없다」고 답했습니다. 놓친 1개는 세 조건 모두 같은 문항(스마트폰 성능조절 판결의 징벌적 손해배상 배수)이었고, 발췌에 없는 숫자로 「1배」라고 답했습니다.
같은 문항으로 짝지어 비교(McNemar 정확 검정, 299문항. 「A만」은 A만 맞히고 B는 틀린 문항 수)
| 비교 | A만 / B만 (p) |
|---|---|
| Nanbeige 생각 켬(다시 돌림) vs qwen3.8 27B 생각 켬 | 6 / 26 (0.001 미만) |
| Nanbeige 생각 켬 vs qwen3.8 27B 생각 켬 | 5 / 38 (0.001 미만) |
| Nanbeige 생각 끔 vs qwen3.8 27B 생각 끔(71.2%) | 10 / 29 (0.003) |
| Nanbeige 생각 켬(다시 돌림) vs 생각 끔 | 31 / 14 (0.016) |
| Nanbeige 생각 켬 vs 생각 끔 | 26 / 22 (0.67) |
| Nanbeige 생각 켬(다시 돌림) vs gemma4 12B | 26 / 14 (0.08) |
| Nanbeige 생각 켬(다시 돌림) vs Raon-1 mini 생각 켬(74.2%) | 11 / 22 (0.08) |
읽는 법:
- qwen3.8 27B와의 차이는 어느 조건으로 비교해도 유의합니다. 출력 한도 문제를 바로잡은 뒤에도 7점 가까이 낮습니다.
- 생각 모드는 바로잡은 뒤에야 도움이 되는 것으로 나왔습니다. 처음 잰 값(66.2%)만 보면 생각 끔과 차이가 없었는데, 한도에 걸린 29문항(그중 빈 답 20개)이 생각 켬 쪽 점수를 깎고 있었습니다. 다만 31 / 14(p=0.016)는 한도에 걸린 문항만 다시 돌린 숫자라 생각 켬 쪽에 유리합니다.
- 생각을 켜면 표 문항이 54%에서 70~76%로 오릅니다(50문항 중 27개에서 35~38개). 텍스트 문항은 처음 잰 값에서 71%가 64%로 내려갔지만 45문항 중 3개 차이입니다.
두 번째 채점기로 다시 보기
주 채점기 qwen3.6 27B는 비교 대상 qwen3.8 27B와 같은 Qwen 계열입니다. 그래서 「채점기가 qwen 편을 들었나」를 확인하려고, 다른 모델들처럼 Claude Opus 5.5로 같은 프롬프트를 써서 한 번 더 채점했습니다.
| 모델 | 주 채점기 | Opus 5.5 | 차이 | 두 채점기 일치 |
|---|---|---|---|---|
| qwen3.8 27B, 생각 켬 | 77.3% | 80.6% | +3.3 | 95.3% |
| Nanbeige 생각 켬 | 66.2% | 69.2% | +3.0 | 96.3% |
| qwen3.8 27B, 생각 끔 | 71.2% | 72.2% | +1.0 | 97.0% |
| Nanbeige 생각 끔 | 64.9% | 66.9% | +2.0 | 96.0% |
- Opus가 두 모델 모두 비슷하게 1~3점 후하게 줬습니다. qwen 채점기가 qwen3.8 27B만 더 후하게 준 흔적은 없습니다.
- Opus 채점으로도 Nanbeige(다시 돌림, 73.2%)는 qwen3.8 27B(80.6%)보다 낮습니다(3 / 25, p 0.001 미만).
- 채점기에 따라 달라진 비교가 두 개 있습니다. Nanbeige(다시 돌림)와 gemma4 12B는 주 채점기로 차이가 없었지만(26 / 14, p=0.08), Opus로는 Nanbeige가 높았습니다(23 / 8, p=0.01). 생각 끔 카드 설정과 qwen3.8 27B 생각 끔은 반대로, 주 채점기로는 유의했고 Opus로는 유의하지 않았습니다(아래).
출력 한도에 걸린 문항: 무엇이 잘못됐고 어떻게 다시 쟀나
처음 결과를 보고 이상했던 게 빈 답 22개였습니다. qwen3.8 27B는 생각 켬에서 출력 한도 8,192토큰에 걸린 문항이 하나도 없었고, 가장 길게 생각한 문항도 4,558토큰이었습니다(Raon-1 mini는 16개가 걸렸습니다). Nanbeige는 29문항이 한도에 닿았고, 그중 20개는 생각하다 잘려서 답이 비어 있었습니다. 나머지 빈 답 2개는 한도 전에 끝났는데 답이 비어 있었습니다.
처음 측정의 결함은 두 가지였습니다.
- 한도에 걸린 답을 그대로 오답으로 셌습니다. 그 29문항 중 맞은 건 4개뿐이었습니다.
- 생각 내용을 저장하지 않았습니다. 그래서 「깊이 생각하다 잘린 것」인지 「같은 말을 되풀이하다 잘린 것」인지 알 수 없었습니다.
29문항만 따로 다시 돌렸습니다.
| 다시 돌린 방법 | 29문항 중 정답 | 한도 안에 스스로 끝낸 문항 | 생성 토큰 중앙값(생각 포함) |
|---|---|---|---|
| 처음(온도 0, 한도 8,192, 문맥 16k) | 4 | 0 | 8,192 이상 |
| 온도 0, 한도 20,480, 문맥 32k | 15 | 26 | 7,158토큰 |
| 카드 권장(온도 0.6, top_p 0.95), 한도 20,480, 문맥 32k | 17 | 26 | 5,207토큰 |
두 가지가 눈에 띄었습니다.
- 온도 0으로 같은 프롬프트를 다시 돌렸는데, 29문항 중 19개가 이번에는 8,192토큰 안에서 끝났습니다. 처음에 8,192토큰을 넘겼던 문항 중에는 다시 돌리니 422토큰, 714토큰 만에 끝난 것도 있었습니다. 다만 이 재실행은 문맥(16k에서 32k), 한도, 모델 일부(약 4.2GB)가 CPU로 넘어간 것까지 한꺼번에 바뀌었습니다. 또 29문항 중 4개는 프롬프트가 1만 토큰을 넘어서, 처음 실행에서는 프롬프트와 생각을 합치면 문맥 16k를 넘었습니다. 그래서 원인을 하나로 짚을 수는 없습니다. 처음의 한도 초과는 「생각할 게 많아서」라기보다 조건이 조금만 바뀌어도 길어졌다 짧아졌다 하는 불안정이었을 가능성이 큽니다.
- 한도를 2만 토큰으로 올려도 3문항은 또 잘렸습니다. 그중 한 문항은 생각 끝부분에서 「최종 답변: 문서에서 찾을 수 없습니다…」를 계속 되풀이하고 있었습니다. 반복 고리를 직접 확인한 사례입니다.
카드 권장 샘플링은 생각을 짧게 만들었지만, 온도 0과 정답 수 차이(17 대 15)는 우연 범위입니다(p=0.69). 같은 확인을 Raon-1 mini에서도 했을 때 온도 0이 222개, 카드 설정이 224개 맞혔습니다. 이 시험지에서 온도 0 자체가 점수를 크게 바꾸지는 않았고, 점수를 바꾼 건 잘린 답을 오답으로 센 것이었습니다.
생각 끔에서도 비슷한 일이 있었습니다. 320문항 중 92개가 출력 한도 1,024토큰에서 잘렸습니다. 다른 모델은 생각을 끌 수 없는 gpt-oss 20B(76개)를 빼면 0~1개였습니다. 한도를 4,096으로 올려 다시 돌렸더니 45개가 또 잘렸고, 43개는 답 문장 자체를 되풀이하고 있었습니다. 예를 들면 한 답은 「2023년에 비해 2027년에 의무지출의 비중은 2.8% 증가했습니다.」를 처음 실행(한도 1,024)에서 여섯 번, 한도 4,096 재실행에서 열다섯 번 쓰고 잘렸습니다. 정답 수는 70에서 72로 바뀌어 차이가 없었습니다(전체 64.9%에서 65.6%). 다만 채점기는 답의 앞 3,000자만 읽기 때문에, 3,000자를 넘긴 44개 답은 끝부분이 채점에 들어가지 않았습니다. 카드 권장 설정(온도 0.6, top_p 0.95)으로 생각 끔 320문항 전체를 다시 돌려 봤습니다. 정답률은 65.6%로 온도 0과 차이가 없었고(18 / 16, p=0.86), 같은 줄이 세 번 이상 나온 답은 19개로 그대로였습니다. 1,024토큰 한도에 잘린 답은 오히려 92개에서 118개로 늘었습니다. 이 설정에서도 qwen3.8 27B 생각 끔보다 낮습니다(14 / 31, p=0.016). 다만 두 번째 채점기로는 18 / 30(p=0.11)이라, 생각 끔 비교는 채점기에 따라 유의성이 갈립니다. 생각 끔 Nanbeige는 같은 문장을 되풀이하는 일이 잦고, 한도를 올려도, 샘플링을 바꿔도 나아지지 않았습니다.
그래서 측정 도구를 이렇게 고쳤습니다.
- 생각 내용과 「왜 멈췄는지(한도에 걸렸는지, 스스로 끝냈는지)」를 항상 저장합니다.
- 보고서 맨 위에 한도에 잘린 문항 수(5개 넘을 때), 빈 답 수, 끝부분 4,000자 안에 같은 줄이 세 번 이상 나온 답 수를 경고로 띄웁니다. qwen3.8 27B, gemma4 12B, Raon-1 mini(생각 끔)의 이전 측정에 돌려 보니 이 세 가지 경고는 하나도 뜨지 않았습니다.
- 모델 카드가 권장하는 샘플링 값(온도, top_p, 그리고 카드에 따라 top_k, repeat_penalty)을 옵션으로 넣었습니다.
리더보드에는 다른 모델과 같은 조건인 66.2%와 64.9%를 올리고, 다시 돌린 70.6%는 이 글에 따로 적었습니다. 70.6%는 29문항만 다른 조건(문맥 32k, 카드 설정)으로 바꿔 넣은 숫자라서, 다른 모델과 완전히 같은 조건은 아닙니다.
눈에 띈 차이
- 생각 끔 답이 깁니다. 글자 수 중앙값이 633자로, 생각 켬 qwen3.8 27B(359자)의 두 배 가까이 됩니다. 위에서 말한 문장 반복이 길이를 늘린 경우가 많습니다.
- 생각을 켜면 답이 짧아집니다(중앙값 213자). 생각 쪽에서 정리를 끝내고 답만 쓰는 모습입니다.
- 이미지 문항(텍스트가 그림 속에만 있는 문항)은 30~37%로 다른 모델처럼 낮습니다. 57문항뿐이라 참고만 하세요.
속도: RTX 3090
같은 30문항, 생각 끔, 문맥 12,288, 모델 전체가 GPU에 올라간 것을 확인하고 잰 중앙값입니다. 같은 프롬프트가 qwen3.8 27B 토크나이저로는 약 3,200토큰, Nanbeige 토크나이저로는 약 5,100토큰입니다. Nanbeige는 이 30문항 중 6개가 출력 한도 1,024토큰까지 갔습니다.
| Nanbeige4.3 33B (Q4_K_S) | qwen3.8 27B (Q4_K_M) | |
|---|---|---|
| 생성 | 초당 37.8토큰 | 초당 84.5토큰 |
| 프롬프트 처리 | 초당 약 1,370토큰 | 초당 약 1,270토큰 |
| 생성 토큰 중앙값 | 448 | 91 |
| 문항당 | 17.8초 | 4.0초 |
- 생성에 걸린 시간은 중앙값 11.8초 대 1.0초입니다(속도 2.2배 차이에 생성 토큰 약 5배 차이). 프롬프트를 읽는 시간(3.8초 대 2.6초)이 더해지면서 문항당 차이는 4.4배가 됩니다.
- 생각을 켜면 문항당 중앙값이 41초였습니다(320문항 본 측정).
- 문맥을 32k로 늘리면 3090(24GB)에 다 올라가지 않고 4.2GB가 CPU로 넘어갑니다. 이때 생성은 초당 약 11토큰으로 떨어졌습니다.
- 19.7GB라 GTX 1080 Ti(11GB) 한 장에는 들어가지 않습니다. 1080 Ti 두 장으로는 재지 않았습니다.
한계
- 한 번씩만 돌렸습니다. 위에서 봤듯 이 모델은 온도 0에서도 다시 돌리면 답이 달라지는 문항이 있습니다. 2~3%p 차이는 순위로 읽지 마세요.
- 양자화가 다릅니다. Nanbeige는 Q4_K_S, qwen3.8 27B는 Q4_K_M입니다. 한 단계 차이가 7점 차이를 설명할 가능성은 낮지만, 재지는 않았습니다.
- 「다시 돌림」 70.6%는 29문항만 조건을 바꿔 넣은 숫자입니다. 320문항 전체를 카드 설정으로 돌린 값은 아닙니다. 한도에 걸린 문항만 두 번째 기회를 받았으니 이 숫자에 유리합니다. qwen3.8 27B는 한도에 걸린 문항이 없어서 이 비교는 대체로 공정하지만, Raon-1 mini는 생각 켬에서 16문항이 한도에 걸렸는데 다시 돌리지 않았습니다. 그래서 Raon과의 비교(11 / 22)는 Nanbeige 쪽에 유리하게 기울어 있습니다.
- 본 측정은 모든 모델을 온도 0으로 돌렸고, 카드는 온도 0.6을 권장합니다. 생각 끔은 320문항 전체를, 생각 켬은 한도에 걸린 29문항을 카드 설정으로 다시 돌려 확인했습니다. 생각 켬 320문항 전체를 카드 설정으로 돌리지는 않았습니다. 나머지 문항이 그대로라면, 상한에 걸린 29문항을 전부 맞혔다고 쳐도 생각 켬은 74.6%라서, qwen3.8 27B(77.3%)보다 낮다는 결론은 바뀌지 않습니다.
- 카드는 출력 한도 262,144토큰을 권장합니다. 이 측정의 한도는 8,192(다시 돌린 문항은 20,480)입니다.
- 카드는 여러 턴 도구 사용에서
preserve_thinking을 켜라고 하지만, 이 시험지는 한 턴 질의응답이라 해당이 없습니다(카드도 일반 질의응답에는 끄기를 권장). - 채점은 LLM 두 개(qwen3.6 27B, Claude Opus 5.5)가 했고, 사람이 전부 확인하지 않았습니다. 두 채점기의 판정은 95~97% 일치했습니다.
- 한국어 공공 문서 시험지 하나의 결과입니다. 카드가 내세운 에이전트 코딩과 업무 자동화는 재지 않았습니다. 「한국어 문서에서 근거로 답하기」에 한정한 결론입니다.
재현
생성, 채점 스크립트와 문항별 판정은 첫 글의 재현 파일에 추가했습니다. 본 측정은 measure.sh, 한도에 걸린 문항 다시 돌리기는 nanbeige_long.sh와 nanbeige_bc.sh, 생각 끔 카드 설정은 nanbeige_offcard.sh, 합치기는 merge_rerun.py, 그림은 figs_nanbeige.py입니다.
다음에 읽을 글
- 한국어 문서 RAG 리더보드: 이 시험지로 채점한 모든 모델과 조건을 한 표로 모은 페이지
- 로컬 RAG, 한국어 문서에 정말 맞게 답할까 (300문항 채점): 이 글의 시험지와 qwen3.8 27B 결과
- 엔비디아 Nemotron 3.5 Bolt E4B, 한국어 문서 RAG 300문항으로 채점해 보니: 같은 틀로 잰 4B급 모델
- 크래프톤 Raon-1 mini, 한국어 문서 RAG 300문항으로 채점해 보니: 같은 시험지로 잰 국산 MoE
관련 글
엔비디아 Nemotron 3.5 Bolt E4B, 한국어 문서 RAG 300문항으로 채점해 보니: 바탕 모델 gemma4 E4B와 같은 조건 비교
10월 26일 · 17 min read
Local LLMNanbeige4.3 33B on a Korean Document-QA Benchmark: The Model That Leads qwen3.8 27B on Its Card, Compared Under the Same Conditions
10월 28일 · 14 min read
AI/ML크래프톤 Raon-1 mini, 한국어 문서 RAG 300문항으로 채점해 보니: 3090 한 장·1080 Ti 두 장에서 돌린 결과
10월 22일 · 18 min read
AI/ML로컬 RAG, 한국어 문서에 정말 맞게 답할까 — 정답 있는 300문항으로 채점해 보니 로컬 27B가 Opus 5.5와 비겼고, 남은 점수는 파싱과 검색에서 샜다
10월 21일 · 34 min read